
在公开数据采集(如电商比价、行业舆情监控)以及企业级 QA 自动化回归测试中,腾讯云天御验证码(原“腾讯防水墙”,常见标识为 TCaptcha 或 TJCaptcha)是开发者最常遇到的风控组件之一。
随着腾讯云近期连续升级防护策略——包括引入滑块混淆模式、随机弹出认证方式(在滑块拼图、文字点选、六宫格、空间推理之间动态切换)以及域名强校验模式——传统的“OpenCV 缺口识别 + Selenium 轨迹拖动”方案维护成本急剧上升。一旦目标站开启随机弹出策略,原本针对单一滑块编写的视觉裁剪和 DOM 操作脚本就会直接失效。
本文将从腾讯验证码的底层交互机制出发,拆解如何通过 NexCaptcha 验证码识别 API 实现对腾讯验证码的稳定处理,覆盖从参数提取、异步任务调度到凭证回填与异常排查的完整工程链路。
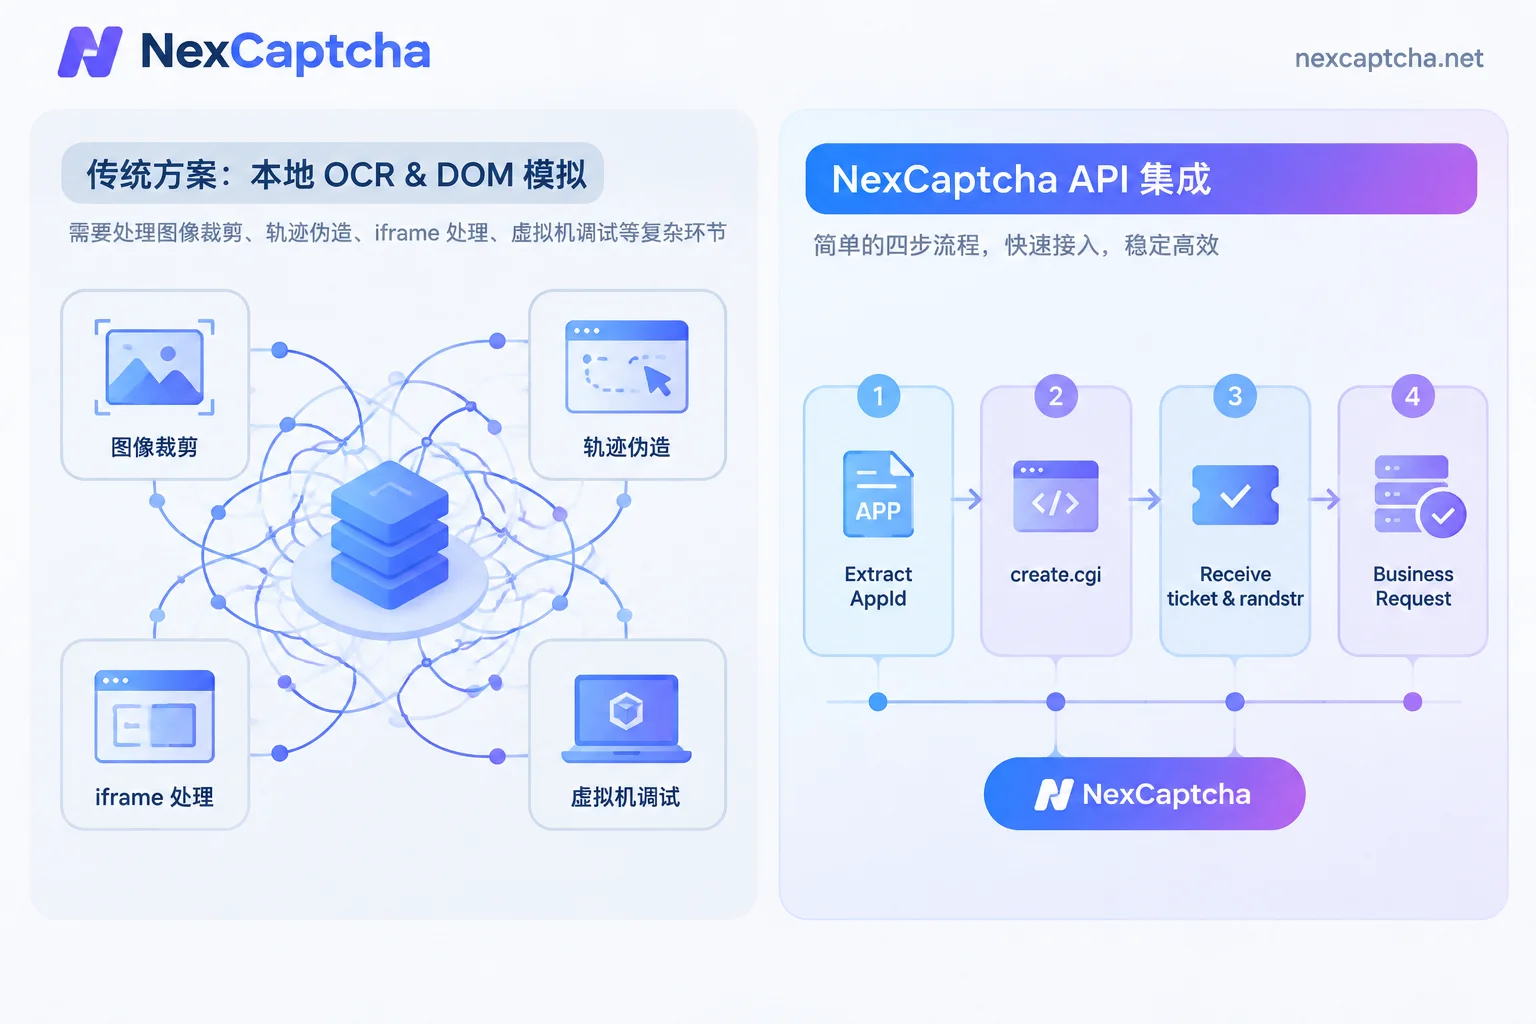
一、 为什么传统的本地 OCR 与轨迹模拟越来越难维护?
在评估验证码识别自建还是选打码平台时,许多团队最初会尝试用开源视觉库配合浏览器自动化工具来处理腾讯滑块。但在实际生产环境中,这种方案面临三重技术壁垒:
- 题型动态切换(随机弹出模式):腾讯云支持根据实时风险评分动态下发挑战类型。同一次会话中,第一次可能是滑块拼图,第二次就变成按序点击汉字或图标点选。维护多套本地识别模型与 DOM 交互逻辑不仅耗时,还会显著增加容器内存开销。
- 跨域 iframe 与动态虚拟机(tdc.js):腾讯验证码的交互运行在独立的跨域 iframe(如
turing.captcha.gtimg.com)中。其核心环境采集与行为加密逻辑由动态生成的tdc.js(CHAOS VM 字节码虚拟机)驱动,每次加载时加密密钥、操作码索引和模块调用顺序都会动态变化,且对 DOM 事件、浏览器指纹和 PoW(工作量证明)有严格校验。 - 域名强校验与容灾票据陷阱:在域名强校验模式下,非目标域名上下文发起的异常请求会被直接拦截;若本地补环境或轨迹仿真触发风控,组件有时不会直接报错,而是返回一个带有
trerror_前缀的容灾票据或错误码,导致后续业务接口校验失败。
为了将研发精力聚焦在核心业务上,更高效的工程实践是将复杂的挑战识别交由专业的 API 服务处理,直接获取最终的验证凭证(或坐标数据),在自己的业务会话中完成提交。
二、 腾讯验证码的核心机制:业务解耦与双凭证校验
观察腾讯验证码的 Web 客户端接入标准可以发现,验证码交互系统与目标站的业务系统是解耦的。
无论前端展示的是新版“我是人类”勾选框(TJNCaptcha-global.js)、传统滑块还是文字点选(TCaptcha.js / TJCaptcha.js),当验证通过后,腾讯验证码组件都会触发前端注册的回调函数 callback(res),返回如下核心数据结构:
{
  "ret": 0,                   // 验证结果,0代表验证成功,2代表用户主动关闭
  "ticket": "t03...",         // 验证成功的票据(核心凭证 1)
  "randstr": "@abc...",       // 本次验证的随机串(核心凭证 2)
  "CaptchaAppId": "204455...",// 验证码应用 ID
  "bizState": null            // 自定义透传参数
}
目标网站的业务后端并不会去检查你滑了多少像素或点了哪个坐标,它只接收前端提交表单时附带的 ticket 和 randstr,然后调用腾讯云服务端接口核验这对凭证的有效性。
这为我们提供了清晰的自动化接入思路:
- 协议直解(Token 模式):提取目标页面的站点地址(
websiteURL)和腾讯验证码应用 ID(CaptchaAppId),通过 API 直接获取合法的ticket和randstr,注入前端回调或直接拼入业务请求体提交。 - 视觉辅助(坐标/距离模式):如果部分定制化极深的业务场景需要完全保留真实浏览器的物理点击/拖动动作,也可以将截取到的背景图与提示图传给通用滑块验证码识别接口或点选验证码识别接口,拿回坐标后再驱动 Playwright/Puppeteer 执行。
三、 接入前准备:如何快速定位关键参数?
在使用 NexCaptcha 处理腾讯验证码前,首先需要在目标页面提取基础配置参数。打开浏览器开发者工具(F12),通常可以通过以下三种方式快速找到 CaptchaAppId(即接口参数中的 websiteKey / appId):
- 检查 DOM 元素属性:查找页面上触发验证的按钮或容器元素,检查是否存在
data-appid等属性。 - 检索全局初始化代码:在 Sources 面板全局搜索
new TencentCaptcha,第一个传入的字符串参数通常就是CaptchaAppId。 - 监听网络请求(最稳妥):在 Network 面板过滤
cap_union_prehandle请求(发往turing.captcha.qcloud.com),查看其 Query String 参数中的aid字段,该值即为当前业务线绑定的CaptchaAppId。
四、 NexCaptcha 腾讯验证码识别 API 接入实战
NexCaptcha 支持包括腾讯、极验、网易易盾、阿里云、reCAPTCHA、Turnstile 在内的数十种主流验证码类型(完整列表可查看官网支持类型页或登录控制台产品目录)。
在接口设计上,NexCaptcha 采用统一的异步任务流:通过 create.cgi 创建识别任务,通过 query.cgi 轮询结果或使用 WebSocket 实时推送接收识别结果,客户自己的业务请求、Session 和 Cookie 完全保留在本地,不经过打码服务端。
1. 接口调用流程与 Python 示例
在调用前,请先前往 NexCaptcha 注册页面 获取 API Key(注册即送测试额度,无需绑卡)。你也可以先在控制台的在线测试台中填入 API Key,发起一次真实的测试任务。
注意:具体产品的编码(product)及adapter内的字段定义,请以最新的 NexCaptcha 官方接口文档 为准。文档在每种类型下均标注了对应的通行 task type 名称,且adapter内部字段沿用了行业通行的websiteURL、websiteKey等命名习惯,方便从其他平台快速迁移。
以下是使用 Python 提交任务并轮询结果的参考结构:
import time
import requests

API_KEY = "YOUR_NEXCAPTCHA_API_KEY"
BASE_URL = "https://app.nexcaptcha.net/openapi"

def solve_tencent_captcha(page_url: str, app_id: str, proxy: str = None):
    headers = {
        "Authorization": f"Bearer {API_KEY}",
        "Content-Type": "application/json"
    }

    # 1. 构造 adapter 参数(具体产品编码与字段名请对照官方接口文档)
    adapter_params = {
        "websiteURL": page_url,
        "websiteKey": app_id
    }
    # 若业务开启了严格的同 IP 校验,建议传入客户自己的代理
    if proxy:
        adapter_params["proxy"] = proxy

    payload = {
        "product": "TENCENT_TASK_CODE",  # 请替换为控制台文档中腾讯验证码对应的产品编码
        "adapter": adapter_params
    }

    # 2. 创建识别任务
    create_resp = requests.post(f"{BASE_URL}/create.cgi", json=payload, headers=headers, timeout=15)
    create_data = create_resp.json()
    task_id = create_data.get("taskId")
    if not task_id:
        raise RuntimeError(f"创建任务失败: {create_data}")

    # 3. 轮询查询结果(高并发场景推荐使用 WebSocket 推送替代轮询)
    for _ in range(30):
        time.sleep(2)
        query_resp = requests.get(
            f"{BASE_URL}/query.cgi",
            params={"taskId": task_id},
            headers=headers,
            timeout=10
        )
        res_data = query_resp.json()
        status = res_data.get("status")

        if status == "success":
            return res_data.get("solution")  # 包含返回的 ticket / randstr 等凭证数据
        elif status in ("failed", "expired"):
            # 任务失败或过期系统会自动退回余额
            raise RuntimeError(f"识别未通过,状态: {status}, 详情: {res_data}")

    raise TimeoutError("查询验证码结果超时")
如果你在 Node.js 或无头浏览器环境中集成,可以参考我们的 Node.js 验证码识别接口接入指南 与 Puppeteer 验证码接口接入实战。
2. AI Agent 与 MCP 零代码集成
如果你的团队正在使用 Claude Code、Cursor、VS Code 或自研 AI Agent 执行自动化巡检与网页交互,无需手写上述 HTTP 轮询代码。NexCaptcha 提供了托管的 MCP(Model Context Protocol)服务,无需本地部署,仅凭 API Key 即可鉴权接入。AI 助手可通过内置的五个标准工具自主完成查产品、查参数模型、创建任务与获取结果(详见 AI Agent 时代的自动化破局:从 MCP 集成到无缝验证码识别实战)。
五、 结果回填与凭证注入的两种模式
拿到 API 返回的验证结果(包含 ticket 和 randstr)后,如何将其交还给目标网站?根据自动化架构的不同,通常有两种处理方式:
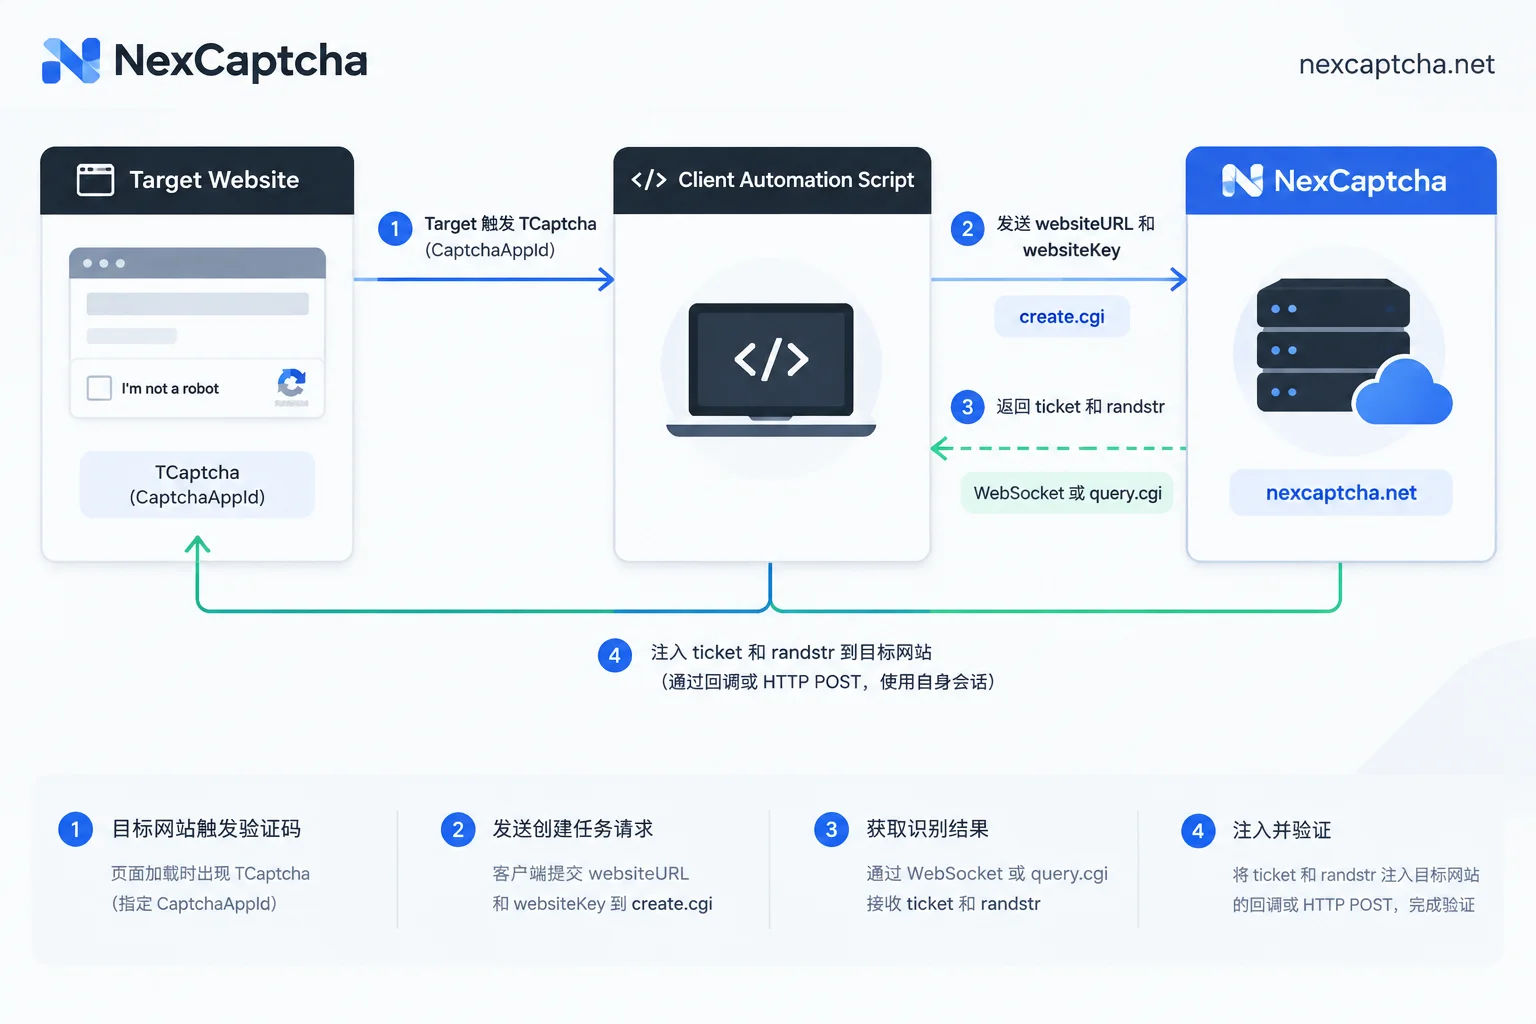
模式 A:纯 HTTP 协议直提(适合高并发数据采集)
在许多公开数据查询或登录接口中,前端在触发风控(例如返回 HTTP 430 或特定业务错误码并下发 contextId)后,只是要求在重发请求或调用校验接口时带上 ticket 和 randstr。
此时无需启动浏览器,直接将 API 返回的凭证拼入你的业务 POST 请求体(例如 {"ticket": "...", "randstr": "..."}),用你原本的业务 Session 直接提交即可。这种方式单机并发高、内存占用极低。
模式 B:Playwright / Selenium 回调注入(适合 QA 回归测试)
在端到端 UI 自动化测试中,业务后续逻辑往往绑定在前端 TencentCaptcha 实例的回调函数里。此时可以通过 page.evaluate() 在浏览器上下文中直接触发该回调,或者将凭证写入隐藏表单项:
// 在 Playwright / Puppeteer 中注入识别结果示例
await page.evaluate(({ ticket, randstr, appid }) => {
  const mockRes = {
    ret: 0,
    ticket: ticket,
    randstr: randstr,
    CaptchaAppId: appid,
    bizState: null
  };
  // 如果页面将回调挂载到了全局或特定实例,直接调用它
  if (typeof window.onCaptchaCallback === 'function') {
    window.onCaptchaCallback(mockRes);
  }
}, { ticket: solution.ticket, randstr: solution.randstr, appid: '2044554539' });
六、 常见报错与避坑指南(为什么拿到 Ticket 还是校验失败?)
在联调腾讯验证码时,有时会遇到接口成功返回了凭证,但提交给目标站业务接口却提示验证失败的情况。结合腾讯云官方的服务端票据校验错误码及工程经验(可延伸阅读 验证码 token 返回后验证失败怎么排查),请重点排查以下四点:
| 常见现象 / 腾讯云错误码 | 核心原因分析 | 工程解决对策 |
|---|---|---|
7: captcha no match | randstr 和 ticket 不匹配。 | 确保同一次任务返回的 ticket 和 randstr 成对提交,切勿在并发队列中混用不同任务的返回值。 |
8: verify timeout | 票据过期。前端生成 ticket 后,默认有效时长为 5 分钟(部分高敏业务可能缩窄)。 | 遵循“即用即取”原则,不要预先批量囤积票据;拿到结果后立即发起业务请求。 |
9: Sequence repeat | 票据被重复校验。 | 每个 ticket 均为一次性消耗品,若业务请求因网络超时重试,必须重新调用 API 获取新票据。 |
15: decrypt fail 或域名拦截 | CaptchaAppId 传错、字段值被截断,或触发了腾讯云的“域名强校验模式”与 IP 一致性风控。 | 1. 核对传入的 websiteURL 是否包含完整的协议与路径(需与触发验证的真实页面一致);2. 在创建任务时传入与你业务请求出口一致的代理 IP(Proxy),保持会话网络环境对齐。 |
此外,在进行平台切换(如从 2Captcha、Anti-Captcha 或传统图文打码平台迁移至 NexCaptcha)时,由于各家外层路由与鉴权格式不同,建议先按小流量比例双跑,对比有效成本与通过率后再全量切换(参考 超级鹰替代方案与架构演进实战)。
结语
面对腾讯验证码不断迭代的混淆滑块、动态点选与虚拟机加固,将识别环节解耦并交由 NexCaptcha 这样的标准化 API 处理,能够让工程团队彻底告别繁琐的逆向补环境与模型重训。
NexCaptcha 采用按次计费模式,任务失败或过期自动退回余额,无订阅费与最低消费限制,并支持支付宝、微信、USDT 及对公转账(查看价格与计费详情)。立即免费注册获取 API Key 体验在线测试台,如果在接入特定样本或定制场景时有任何疑问,欢迎随时联系我们的 Telegram 在线客服 或访问行业解决方案页获取技术支持。


