
网页 AI Agent 遇到验证码时,不建议让大模型自己截图、看图、点击。更稳的做法是把验证码处理做成一个职责明确的外部工具:
- Agent 发现页面被拦截,并决定是否调用工具。
- 工具在同一个浏览器会话里完成四件事:提取参数、调用识别服务、注入结果、检查是否放行。
- 整个过程受超时、重试上限和熔断约束。失败后交给人工处理,或者结束任务,不让 Agent 自己换着方式反复尝试。
本文讨论的场景限于自有或获授权的系统、允许的公开数据工作流和无障碍辅助。如果你只是在测试自己的网站,先看文末“测试自家系统”一节,很多情况下用不着付费识别服务。
为什么不让 Agent 直接“看图点验证码”
很多人第一反应是:多模态模型能看懂截图,让它自己点就行。实际运行时会遇到三个问题。
第一,可见部分往往没有题可解。 Cloudflare Turnstile、reCAPTCHA v3、AWS WAF 这类机制,主要依据浏览器环境指纹、行为特征和后台风险评分做判断。页面上可能只有一个勾选框,甚至什么都不显示。模型看懂截图,并不会让这些后台判断变好。
第二,操作本身容易显得机械。 每一步都要经过“截图、推理、输出坐标、点击”,耗时长,坐标也可能偏。拖动轨迹和点击节奏还容易表现出自动化特征。
第三,Agent 不知道失败的原因。 点完没通过,模型通常会换个位置再点,或者刷新重来。这样容易陷入循环,同时消耗上下文和调用费用。
传统的字符图、点选图,模型有时确实能认出来。但交给专门的图形识别任务处理,结果格式固定,成本也更容易核算,更适合放进需要稳定运行的流程。
先划清职责:每一层只做自己的事
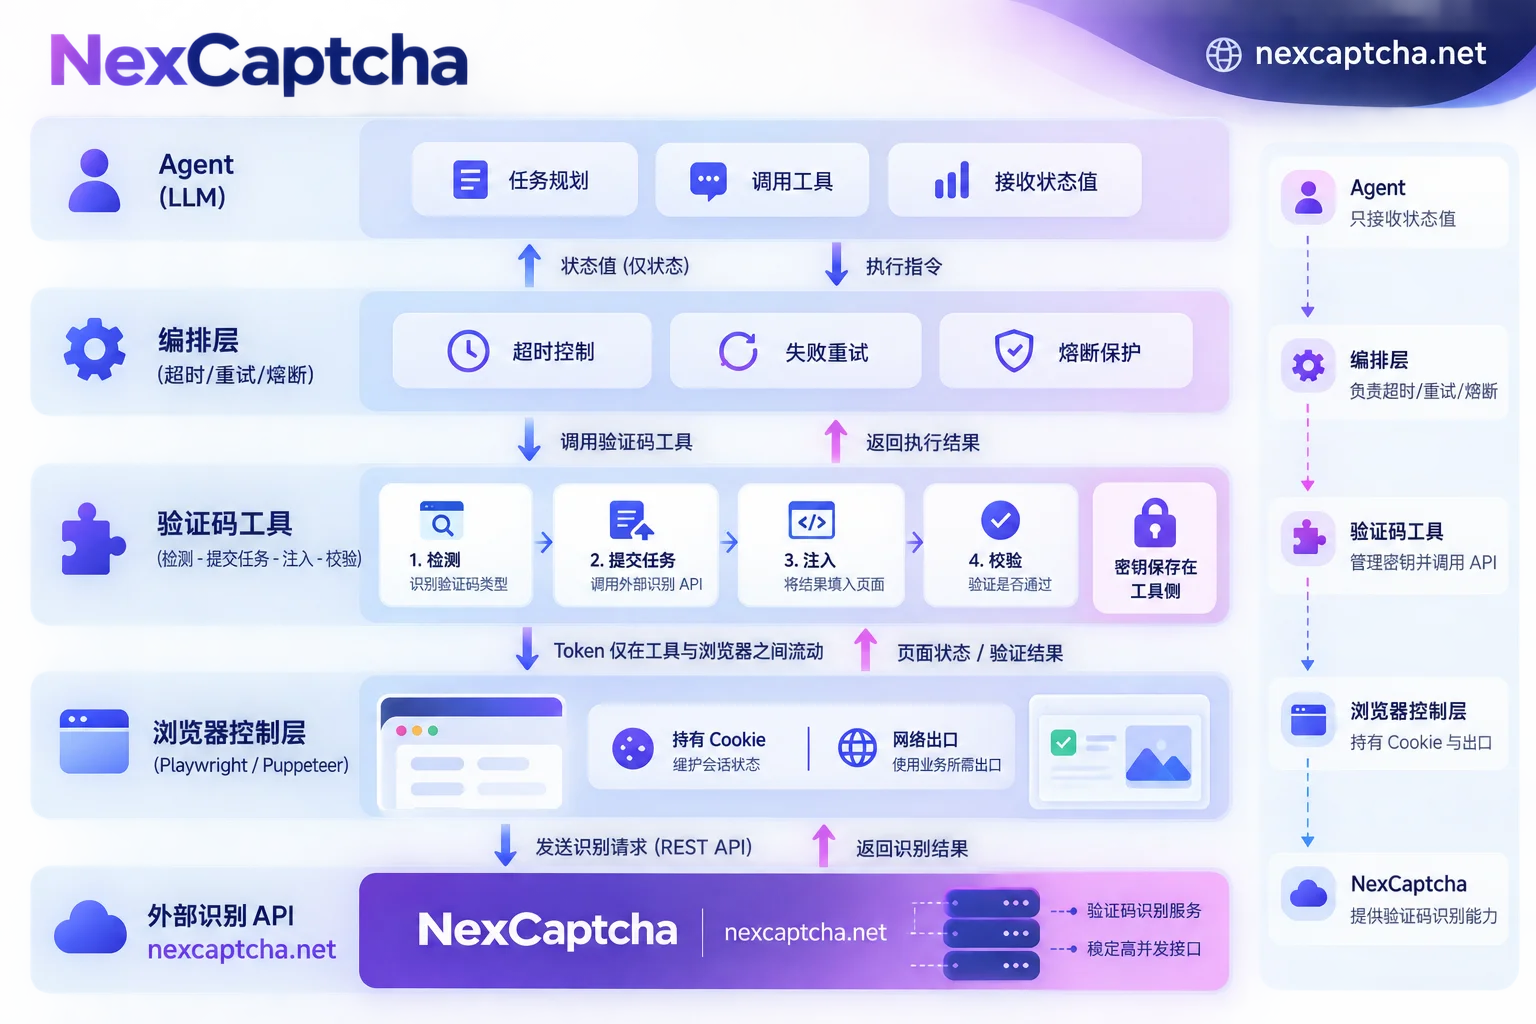
- Agent(LLM):理解任务目标,判断当前页面能不能继续。看到拦截时调用验证码工具,再根据工具返回的状态决定下一步。
- 浏览器控制层(Playwright、Puppeteer、Browser Use 等):持有页面、Cookie 和网络出口,执行 DOM 读取、脚本注入和提交。
- 验证码工具(你自己写的封装):用规则检测验证码类型,组装识别任务,等待结果,回填页面,并检查提交后是否放行。
- 识别服务(打码 REST API):接收任务,异步返回 Token、文字或坐标。
- 编排层:管理超时、重试次数、预算和熔断,并记录日志。
这里有两个容易忽略的细节:
- Token 不要经过 LLM。 识别结果通常是一长串字符。让模型复制粘贴,可能被截断,也会浪费上下文。工具应该在内部直接完成注入,只把状态返回给 Agent。
- 识别服务的密钥不要进入 Prompt 或工具描述。 密钥由工具从环境变量或密钥管理服务读取,Agent 看不到它。
部分识别服务商已经提供面向 LangChain、Browser Use 等框架的封装或 MCP 工具(以各家自述为准)。这些封装底层的分工和上面一样,用不用现成封装都要做到这些边界。
第一步:用规则判断拦截类型
不同类型的验证码,需要的参数和处理方式不同。检测这一步应该优先用代码规则完成,比如匹配 DOM 选择器、iframe 地址和脚本特征。不要让模型凭截图猜类型。
- reCAPTCHA v2:有勾选框版和隐形版,需要 sitekey 和页面 URL。
- reCAPTCHA v3:没有交互,按 action 计算评分,所以还需要 action 参数。
- reCAPTCHA Enterprise:需要单独对应 Enterprise 的任务类型,不能按普通 v2/v3 处理。(v2 和 v3 的差异见 reCAPTCHA v2 和 v3 区别。)
- hCaptcha:需要 sitekey,部分页面还有额外参数。
- Cloudflare Turnstile 组件:嵌在表单里,能找到 sitekey,通过后写入
cf-turnstile-response。 - Cloudflare 整页 Challenge:拦的是整个页面。放行结果通常保存在会话里,和组件是两类任务,不要混为一谈。
- 图形、滑块、点选验证码,以及极验 v3/v4:需要截取图片,或者提取各自的初始化参数,返回的结果可能是文字、坐标或一组校验值。
如果识别服务不支持检测到的类型,工具应该直接返回 unsupported,不要勉强尝试。
第二步:一次工具调用完成一个闭环
下面是结构示意伪代码,用来说明职责和返回值。它不是任何服务商可以直接运行的 SDK 代码,字段名请以所用服务的当前文档为准。
# 伪代码:仅示意结构
def handle_captcha(session, max_wait_s=120) -> dict:
    info = detect_captcha(session.page)   # 规则检测:类型、sitekey、页面URL、action等
    if info is None:
        return {"status": "no_captcha"}
    if info.kind not in SUPPORTED_KINDS:
        return {"status": "unsupported", "kind": info.kind}

    task_id = solver.create_task(info.to_task())       # 密钥从环境变量读取
    result = solver.wait_result(task_id, max_wait_s)   # 轮询或回调
    if result.status != "ready":
        return {"status": result.status, "kind": info.kind, "task_id": task_id}

    inject_result(session.page, info, result.solution)  # 回填并触发回调/提交
    accepted = verify_after_submit(session.page, info)  # 是否离开拦截状态
    return {"status": "accepted" if accepted else "rejected",
            "kind": info.kind, "task_id": task_id}
把它注册成 Agent 的工具时,要在工具描述里写清三件事:
- 什么时候调用。
- 返回的各个状态分别是什么意思。
- 同一页面最多调用几次。
此外,在系统提示里明确告诉 Agent:不要自己点击验证码区域。
等待结果可以用轮询,也可以用回调。Agent 任务一般持续时间较长,轮询实现简单。回调需要一个能从公网访问的接收端点,适合并发量大的编排层。两者怎么选,见 验证码API轮询和回调有什么区别。
第三步:结果必须回到同一个会话
很多“Token 拿到了还是过不去”的问题,原因在这一步。
- 参数要从当前页面实时提取。 不要缓存上一次的 sitekey 或 action,页面改版或换路由后它们可能变了。
- 结果到手后立即注入。 Token 有时效。不要让多个 Agent 先领 Token、再排队等着用。
- 只写字段不够,还要触发后续动作。 结果通常写进
g-recaptcha-response、h-captcha-response、cf-turnstile-response等隐藏字段。但很多页面依赖data-callback回调或前端事件才会继续,只写字段,表单不会提交。隐形版本的回调名和触发方式各站不同,需要针对具体页面的脚本核对,没有一套通用写法。 - 环境参数要一致。 有些任务类型要求或允许提交代理、User-Agent 等环境参数。如果提交了,要和浏览器实际使用的出口保持一致。是否需要提交,以对应任务的文档为准。
- 不要随意更换会话。 整页 Challenge 放行后,如果换了网络出口或浏览器上下文,可能会重新触发。
按框架落地的细节,可以参考 Puppeteer 验证码接口怎么接。返回后仍被拒的情况,按 验证码 token 返回后验证失败怎么排查 的顺序逐层定位。
第四步:给 Agent 装上刹车
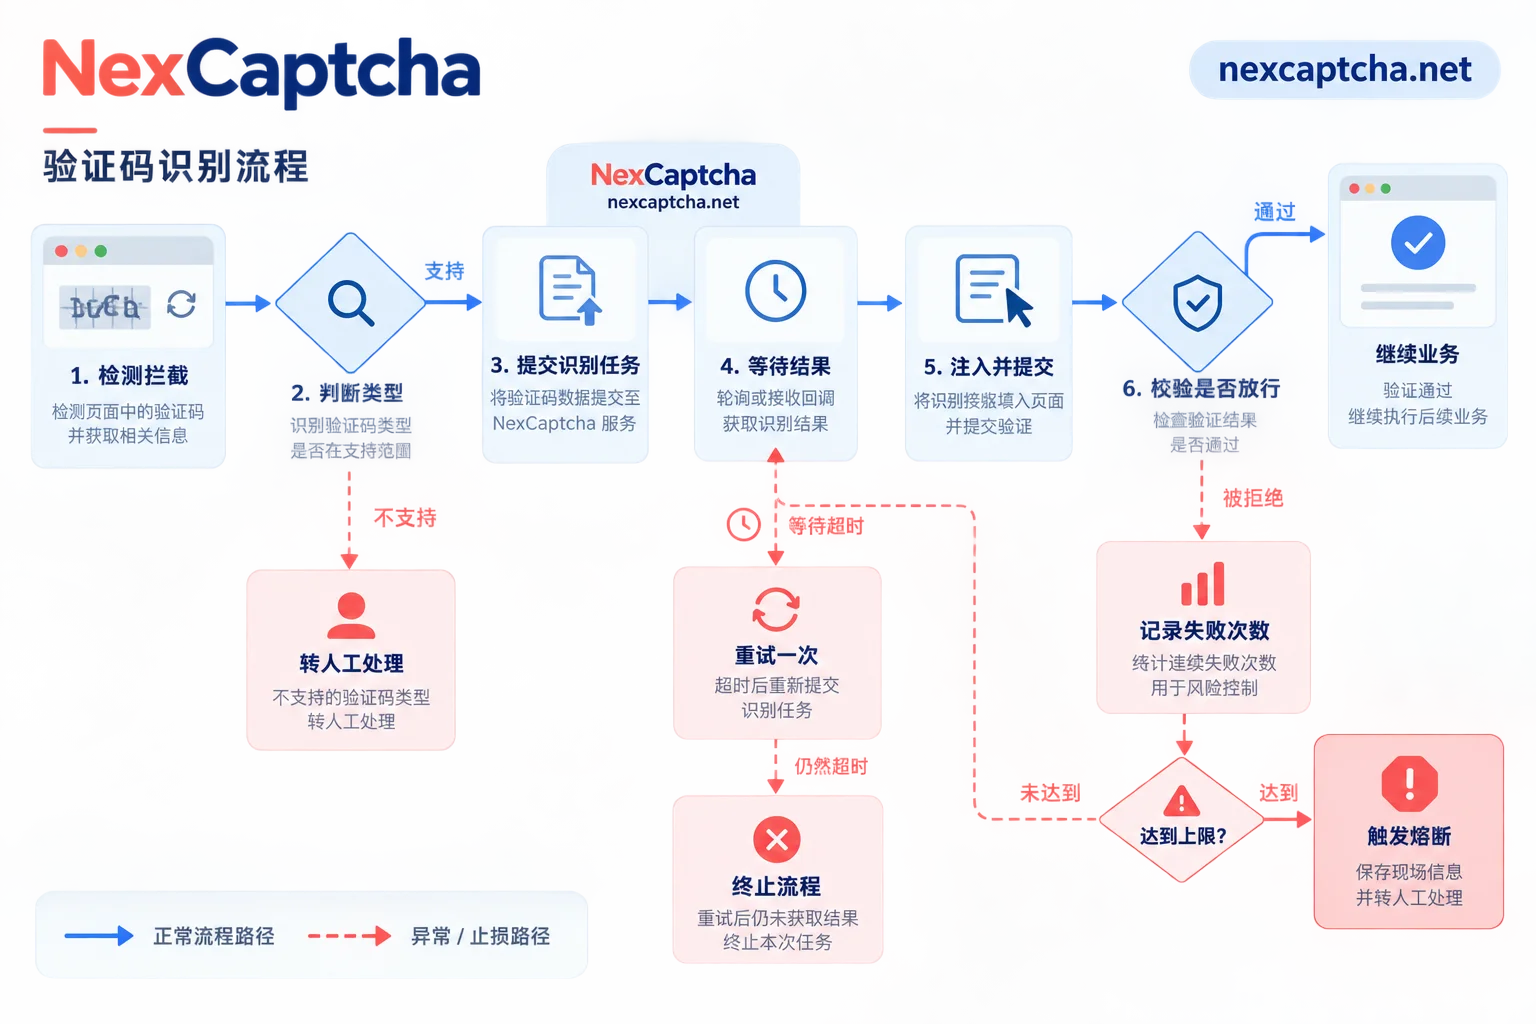
防止死循环要靠编排层的硬性规则,不能指望模型自己停下来。
- 单次等待上限。 识别任务超过设定时间就判为超时,不要无限等待。超时有不同类型,处理方式也不同,见 验证码API超时怎么处理;任务长时间停在 processing,可参考 这篇排查。
- 每页调用上限。 比如同一页面最多调用 2 次。这个数字只是示例,应按业务容忍度来定。
按失败类型分别处理。
unsupported:直接转人工。- 偶发的
timeout:可以重试一次。 - 连续
rejected:说明问题多半出在会话、环境或注入方式上,再换一个 Token 解决不了,应该停止并保存现场(截图、URL、task_id)。
- 站点级熔断。 某个目标站在一段时间内的接受率跌破阈值时,暂停对这个站点的调用,避免持续消耗费用。
- 单个任务的预算上限。 限定每个 Agent 任务最多发起多少次识别调用,花费多少钱。
- 从源头减少触发。 保持会话稳定,控制访问频率,使用信誉良好的网络出口,都能降低验证码出现的概率。但也不要把所有失败都归到 IP 上。
成功要分三层看
- 识别服务返回了结果:只代表任务完成。
- 目标站接受了结果:页面离开拦截状态,表单通过校验。
- 业务完成:Agent 真正拿到了要的数据,或者完成了要做的操作。
日志里分别记录这三层,再加上 task_id、验证码类型和各段耗时。统计接受率时要写明分母是什么:是全部发起的任务,还是返回成功的任务。否则不同时间段、不同服务之间的数据没法比较。
测试自家系统:先别接付费识别
如果 Agent 是在你自己的系统上做 CI 回归,主流验证码厂商一般都提供测试用的 sitekey 或测试模式(具体以各家文档为准)。在测试环境里用它们就能稳定通过,不需要识别服务。真实验证码的联调只留给少量专门用例。做法见 Playwright 验证码测试怎么做。
接入识别服务时要核对什么
以 NexCaptcha 为例,官网介绍的是统一的 REST 任务模式:用 createTask 提交任务,用 getTaskResult 取结果,用 getBalance 查余额,支持轮询和 webhook。官网列出的类型覆盖 reCAPTCHA v2/v3/Enterprise、hCaptcha、Turnstile 与 Challenge、GeeTest 以及多种图形类验证码。计费方面,官网自述按千次成功识别计费,失败退款。
目前没有核验到 NexCaptcha 的官方 MCP 或 Agent 专用包。所以比较实际的做法是按上文结构自己写一层薄封装,把它注册成 Agent 工具。接入前建议按以下顺序确认:
- 你的目标验证码类型在支持列表中。
- 任务字段与当前文档一致。
- 用小流量实测目标站的接受率和 P95 延迟。
- 按 按千次计费的有效单价算法 估算真实成本。
支持的类型、报价和工程师联系方式见 NexCaptcha 官网。


