
在 Node.js 里对接验证码识别接口,本质上要处理两件不同的事:把任务提交出去,以及在结果可用时把它取回来。多数按任务计费的服务都采用同一套异步模型——先 POST /createTask 提交并拿到 taskId,再用 POST /getTaskResult 轮询,或者在提交时给出 callbackUrl 等回调推送(CapSolver、2Captcha 等文档都是这个结构)。在这两步封装稳定之前,先确认你提交的是哪一类验证码,因为它直接决定请求体字段和返回值的用法。
先分清两类任务,别用同一套字段
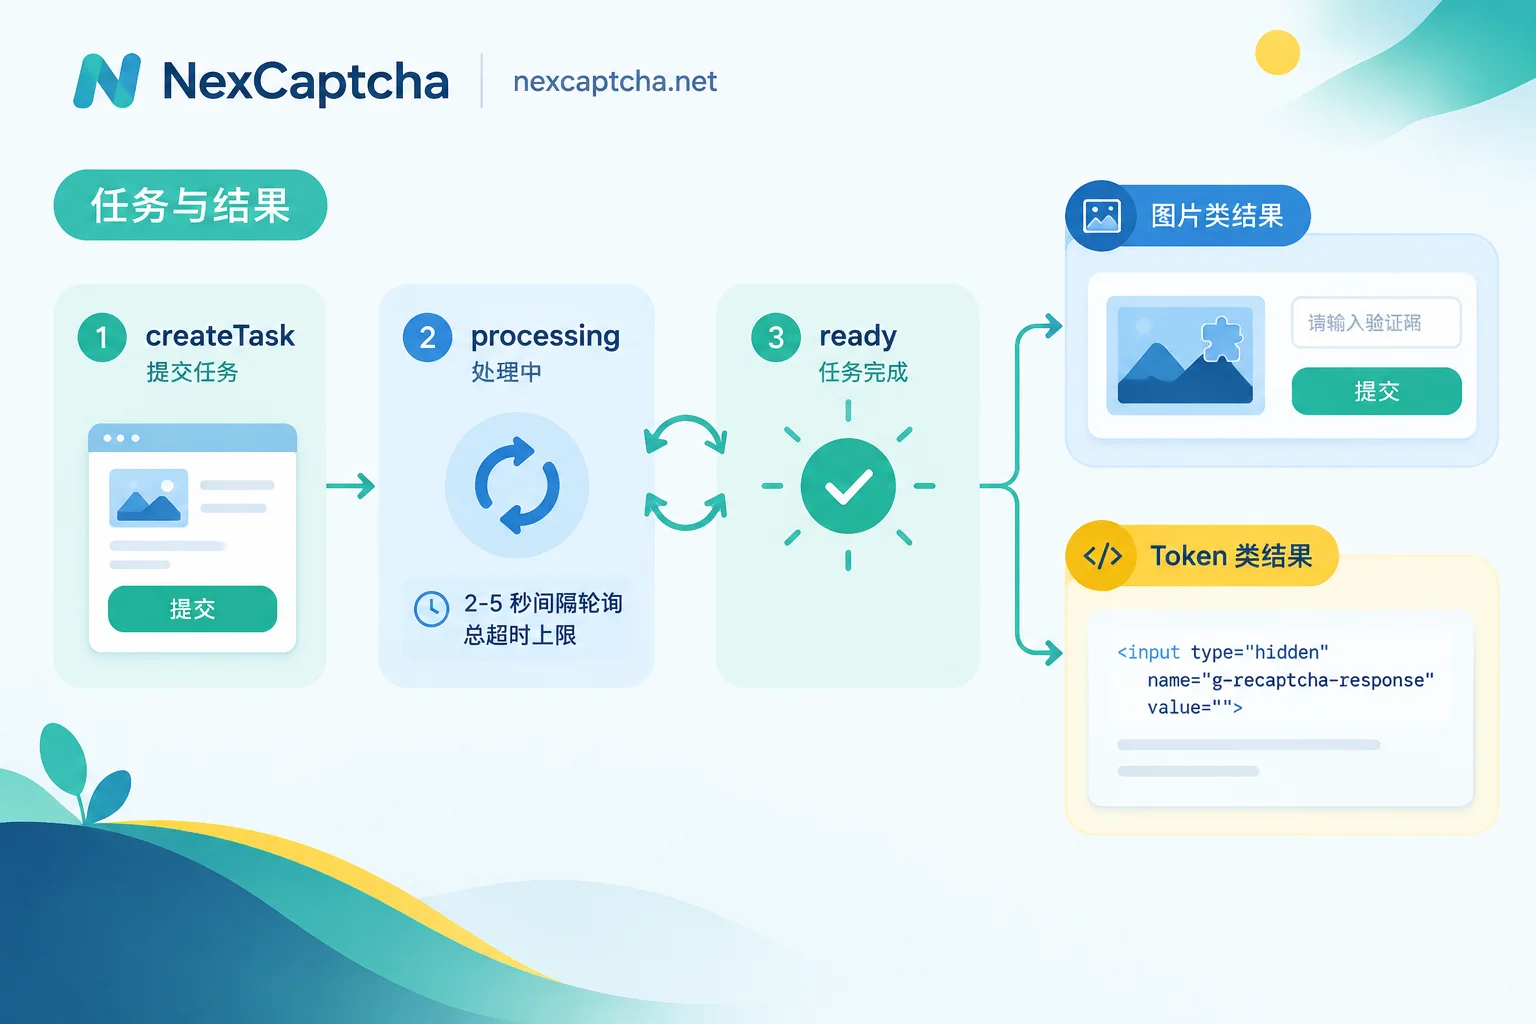
图片/字符类——普通图形验证码、点选、滑块截图。输入通常是 Base64 编码的图片,输出是一段文本(常见字段为 solution.text),你把它填回页面输入框即可。
Token 类——reCAPTCHA v2/v3/Enterprise、Cloudflare Turnstile、hCaptcha、GeeTest 等。输入是 websiteURL、siteKey 和可选参数,输出是一段凭证 token(reCAPTCHA 常返回 gRecaptchaResponse,Turnstile 返回 token)。这段 token 需要注入页面,而不是填进可见输入框。
两类任务最容易踩的坑是判断标准错位:拿到 token 只说明识别服务交付了凭证,目标站点还要做后端校验、评分和会话核对。把"收到结果"当成"流程完成",会让排障方向从一开始就偏掉。另外,Turnstile 组件和 Cloudflare 整页 Challenge 也不是一回事,前者是嵌入页面的组件,后者的触发位置、参数和用途都不同,别把两者的任务混用。
用 Node.js 封装一个最小任务客户端
Node 18 起内置 fetch,不引入额外依赖就够了;习惯 axios 的团队按同样方式替换即可。密钥走环境变量,不要写进代码库,也不要打进日志。
下面的代码是流程示意,字段名以你所选服务当前官方文档为准:
// 伪代码:只示意流程,勿直接用于生产
const KEY = process.env.CAPTCHA_CLIENT_KEY;
const API = process.env.CAPTCHA_API_BASE; // 例如 https://api.example.com

async function createTask(task) {
  const res = await fetch(`${API}/createTask`, {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({ clientKey: KEY, task }),
  });
  const data = await res.json();
  if (data.errorId !== 0) throw new Error(data.errorCode);
  return data.taskId;
}
提交 token 类任务的 task 大致长这样(字段仅为示例结构):
{ type: 'ReCaptchaV2Task', websiteURL, websiteKey, callbackUrl? }图片类任务则把 Base64 图片塞进图片字段。注意任务类型名的拼写和大小写在不同服务间并不统一,迁移时要逐项核对,不要凭印象改。
轮询:间隔、退避和总超时都要设上限
轮询实现最简单,但必须自己设边界,否则最容易出问题的是一个写坏了的 while (true):它不会报错,只会慢慢吃光你的并发和账单。
- 单次间隔建议 2~5 秒,可用固定值,也可以随次数轻微退避;
- 设一个全局总超时,例如 60~120 秒,超时就当本次任务失败进入收尾;
- 每次响应都先看
errorId,非 0 要单独分支处理,别和"还在处理中"混在一起; - 给每个会话设置并发上限,识别任务本质是外部依赖,不能无节制堆积。
如果任务量大或者延迟敏感,回调模式更省资源,但前提是你有一个公网可达、能验签且幂等的接收端;本地开发和 CI 环境通常没有这样的地址,此时轮询更省事。轮询和回调的取舍细节,可以看验证码API轮询和回调有什么区别。
错误处理:把"失败"先分成几类
不同错误的重试策略完全相反,混在一起重试只会放大成本:
- 参数类错误(缺 siteKey、URL 不合法、图片格式不对):重试没有意义,先修请求;
- 鉴权或余额类:不重试,触发告警;
- 仍在处理中:继续轮询,这只是状态,不是错误;
- 识别失败或超时:可以做有限次重试,但要留意重复创建任务可能产生重复计费,业务层最好有去重或幂等键;
- 网络类异常:指数退避重试,并限制最大次数。
一个实用做法是把这几类收敛成明确的返回状态(成功/可重试/不可重试/超时),让调用方只处理三种情况,而不是逐个错误码判断。
拿到结果只算一半:注入和会话匹配
这是 Node.js 场景里最容易被低估的一段。在 Playwright、Puppeteer 或 Crawlee 这类框架里:
- 图片类结果填进对应输入框,然后按页面原有方式提交;
- token 类结果要写入页面指定的隐藏节点,常见如
name="g-recaptcha-response"、name="cf-turnstile-response",或者调用页面暴露的回调函数触发提交; - reCAPTCHA v3、Turnstile 这类依赖信誉分与行为信号的场景,还要尽量保证求解与提交时的 IP、User-Agent、会话一致——不匹配时,token 本身有效也会被拒。
如果返回的 token 被站点拒绝,排查顺序建议是:时效 → 参数与 siteKey 是否对应 → 注入节点是否写对 → 评分与指纹是否匹配。验证码 token 返回后验证失败怎么排查 里有更完整的逐层定位方式,自动化注入部分也可以参考 Playwright 验证码测试怎么做。
什么时候该把这类工作交给托管接口
如果你的团队已经在自建识别模型或维护打码人力,先说清楚一点:图片型验证码在自有或获授权环境里,用官方测试密钥或自训模型往往就够了,没必要为了统一而人为加一层付费调用。托管接口的价值主要出现在三类场景——验证码类型多且经常变化、需要跨区域稳定出结果、以及你不希望把工程资源长期投在识别维护上。
NexCaptcha 提供的是统一 REST 任务接口(任务域名 api.nexcaptcha.net),鉴权用请求体里的 clientKey,任务模式同样是 createTask / getTaskResult 加轮询或 webhook。它的关键特征是按千次成功识别计费、失败退款并提供阶梯量级优惠和测试额度——这些都是官网口径,具体单价、类型覆盖和测试额度请以官网首页与联系工程师时获得的说明为准。官网还宣传对 2Captcha、Anti-Captcha、CapSolver、CapMonster 的部分任务格式兼容,但迁移时请逐任务确认字段名、任务类型大小写、SDK 版本、回调方式和错误码,不要把"兼容"理解成只换域名就能跑通;传统图片上传接口和任务 JSON 接口也不是一回事。
官网有 Python/Node/Go 等多语言 SDK 的宣传,但在你从官方渠道核验到确切的包名、安装命令和方法签名之前,更稳妥的做法是直接用 Node 原生 fetch 封装 REST 请求,而不是安装来路不明的同名第三方包。另外要注意,NexCaptcha 的 clientKey 用于识别接口鉴权,与站内其他产品的 API Key 用途不同,不要混用,更不要把它们写进文章示例、日志或截图。需要看类型覆盖、价格说明和迁移介绍时,入口在 NexCaptcha 官网。
上线前自查
- 密钥只在服务端读取,未出现在前端产物、仓库和日志中;
- 每类任务都验证过请求字段,且类型名与服务文档完全一致;
- 轮询有间隔、总超时和并发上限,不会出现无界循环;
- 错误被归类到可重试/不可重试,并记录足够的排障字段;
- 用小流量在目标环境跑过完整闭环——不只是拿到 token,而是业务动作真的成功;
- 对失败与重复创建的计费口径有明确预期。
把这几步做完,Node.js 侧的接入基本就稳了;剩下的大部分问题,都会落在目标站点的校验规则上,而不是你的 HTTP 客户端里。


