
在公开数据采集(如 SEO 排名监测、电商比价与价格监控)、QA 自动化回归测试以及 AI Agent 浏览器工作流中,Python 依然是主力开发语言。随着团队将基础设施从传统的 requests + Selenium 升级到基于 asyncio、httpx 和 Playwright 的高并发异步架构,验证码处理模块的接入方式也面临重构。
许多团队在早期使用开源 OCR 库处理简单图形验证码,但在面对 Cloudflare Turnstile、reCAPTCHA v2/v3/企业版、极验(GeeTest)v3/v4 或 FunCaptcha 等基于行为风控与动态加密的验证码时,为什么简单的 OCR 方案正在失效?关于这一点的底层逻辑,可以参考我们之前的分析《从防爬升级看企业数据采集策略:为什么简单的OCR方案正在失效?》。在现代风控体系下,工程团队更倾向于通过专业的 Python 验证码识别 API 直接获取验证后的 Token、Cookie 或坐标,并在本地会话中完成提交。
本文将从 Python 异步工程化的视角出发,详解如何直接基于标准 HTTP 与 WebSocket 协议封装 NexCaptcha 自动化打码接口,并实现与 Playwright 浏览器上下文的无缝联调。
一、 为什么在 Python 异步架构中推荐直接封装原生接口?
在评估打码平台时,不少开发者习惯先去 PyPI 搜索第三方封装包。但在生产环境中,直接使用 httpx 和 websockets 对接官方原生接口往往是更稳健的选择:
- 避免同步阻塞破坏 Event Loop:许多老旧的第三方 SDK 底层依赖同步的
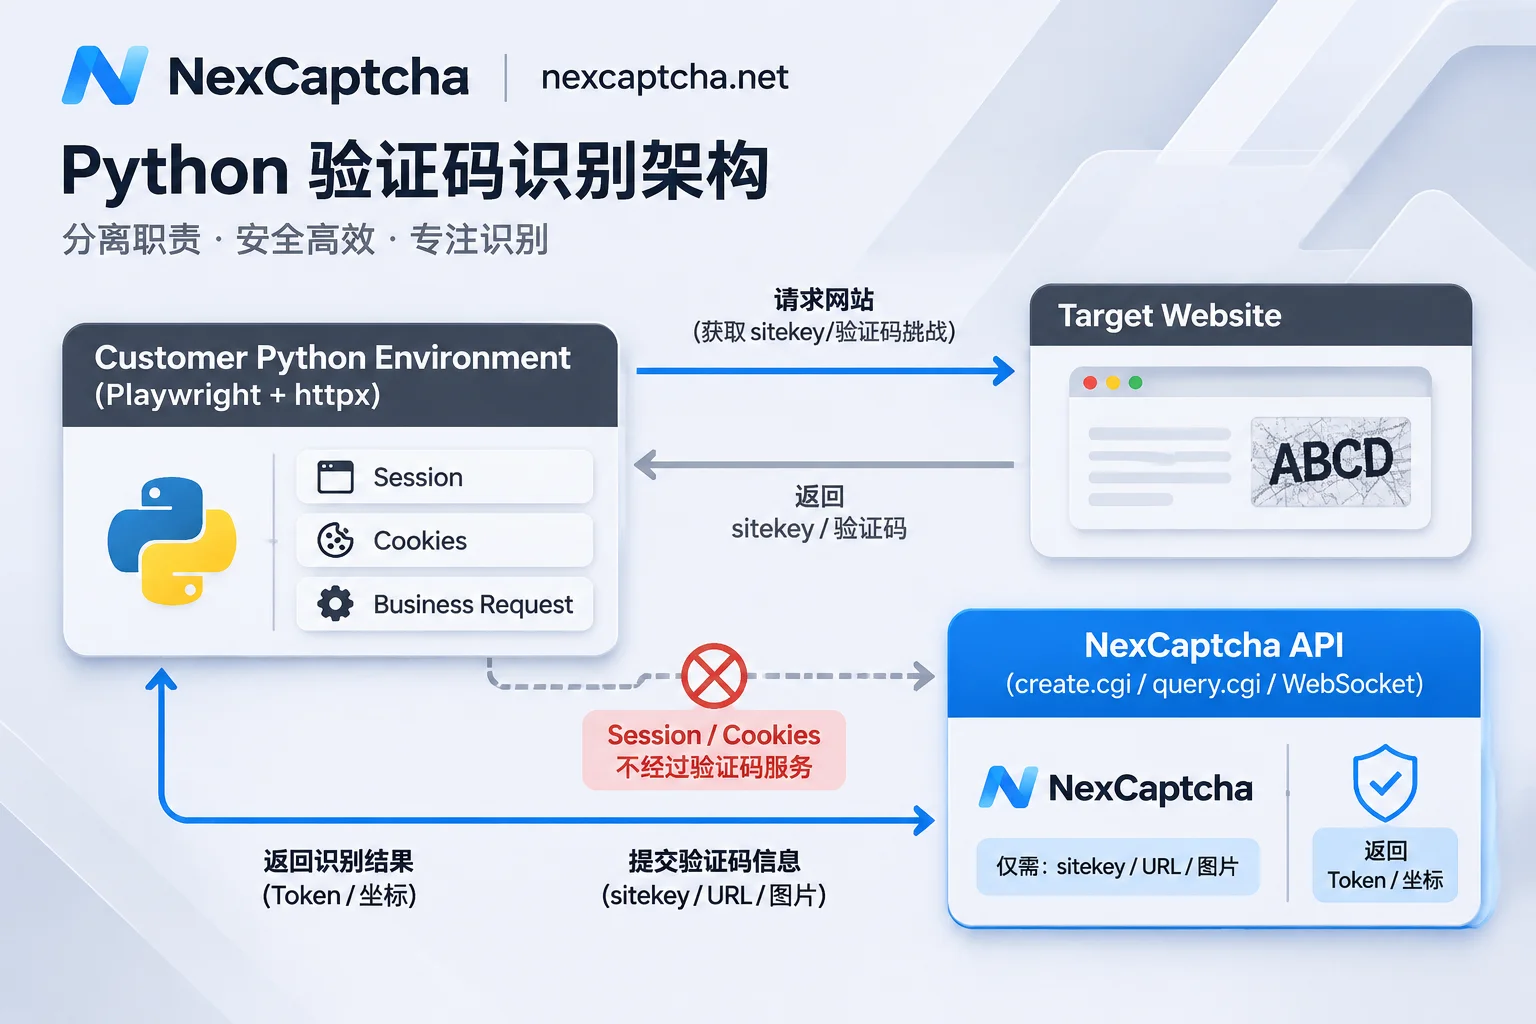
requests与time.sleep()。如果直接放进asyncio协程中运行,会阻塞整个事件循环,导致高并发爬虫或测试任务吞吐量骤降。 - 清晰掌控会话与安全边界:NexCaptcha 的架构设计遵循严格的职责分离——打码接口不替客户发业务请求,也不取回目标页面。你的业务请求、
Session和Cookie完全留在本地 Python 环境中,接口仅根据传入的页面地址、sitekey或图片参数异步返回token、cookie、文字或坐标,最后由你的代码随表单提交。自己维护薄封装层,能更清晰地管理代理 IP 与会话对齐。 - 零依赖滞后:NexCaptcha 目前不提供已核实可安装的官方 Python SDK,而是在接口文档中直接提供清晰的 HTTP 接口与 WebSocket 示例代码。用项目现有的
httpx库编写一个百行以内的客户端类,不仅轻量可控,还能精准定制超时与重试策略。
二、 NexCaptcha 接口协议结构与参数规范
在动手写代码前,先理清 NexCaptcha 与传统 createTask/getTaskResult 平台在接口形态上的核心差异:
- 鉴权方式:API Key 统一放在 HTTP 请求头(Header)中传递,避免将密钥暴露在 URL 查询参数或日志里。
- 端点分工:通过
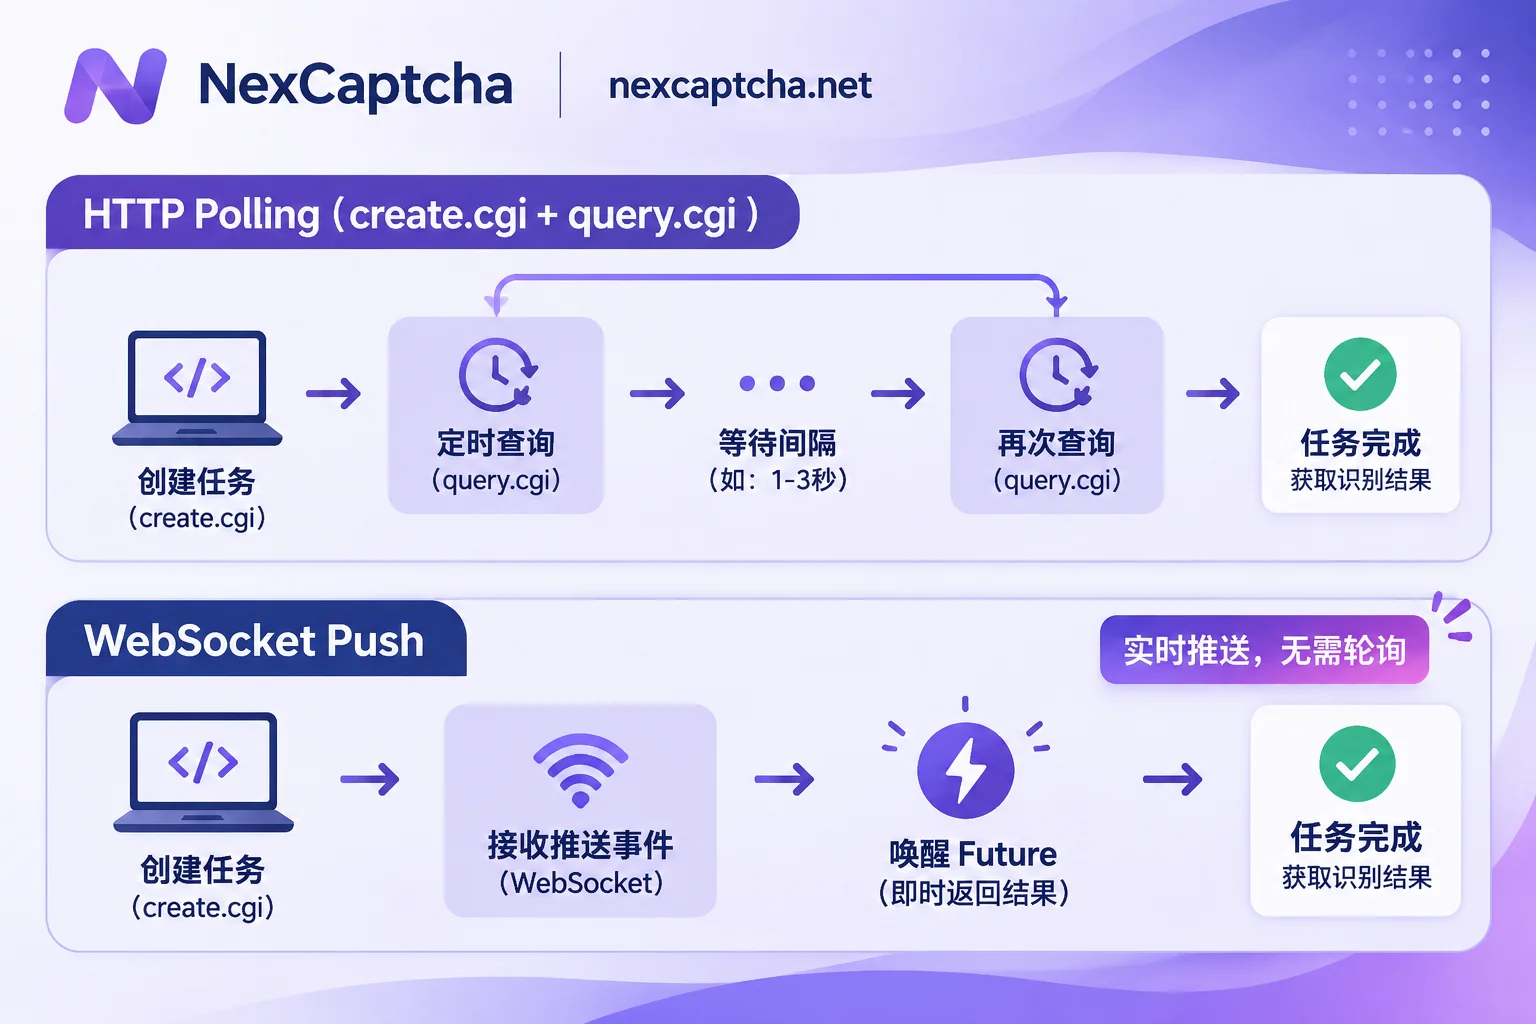
create.cgi创建识别任务,通过query.cgi查询任务结果;除轮询外,也支持通过 WebSocket 推送实时接收识别结果(注:接口不提供 HTTP Webhook 回调)。 - 参数结构(Adapter 模式):请求体按产品编码选择验证码类型,并在
adapter字段内填写该类型的具体参数。为了降低开发者的学习与迁移成本,adapter内部的字段沿用了行业通行的createTask体系命名(如websiteURL、websiteKey等),文档在每种类型下也标明了对应的通行 Task Type 名称(如RecaptchaV2TaskProxyless)。 - 任务状态机:任务生命周期包含处理中、成功、失败、过期四种状态。计费采用按次扣费模式,只有创建任务时扣费,若任务失败或过期会自动退回余额。
在正式编码前,你可以先登录控制台,在支持类型目录中找到对应的验证码类型。每种类型都配备了在线测试台,填入 API Key 即可直接发起一次真实任务,快速核对所需参数与返回格式。
三、 Python 异步客户端封装实战(基于 httpx)
下面我们用 Python 的 httpx.AsyncClient 封装一个通用的异步验证码识别客户端,包含任务创建、状态轮询以及异常止损逻辑。有关各类超时的细分处理原则,建议结合《验证码API超时怎么处理:区分四种超时,再定重试、止损和提交时机》一起阅读。
1. 安装基础依赖
pip install httpx websockets playwright2. 编写异步轮询客户端 (create.cgi + query.cgi)
import asyncio
import time
from typing import Dict, Any, Optional
import httpx

class NexCaptchaError(Exception):
    """验证码识别异常基类"""
    pass

class AsyncNexCaptchaClient:
    def __init__(
        self,
        api_key: str,
        base_url: str = "https://app.nexcaptcha.net/openapi",
        timeout: float = 30.0
    ):
        self.api_key = api_key
        self.base_url = base_url.rstrip("/")
        # 复用连接池,API Key 放在请求头
        self.client = httpx.AsyncClient(
            base_url=self.base_url,
            headers={
                "Authorization": f"Bearer {self.api_key}",
                "X-API-Key": self.api_key,
                "Content-Type": "application/json"
            },
            timeout=timeout
        )

    async def close(self):
        await self.client.aclose()

    async def create_task(
        self,
        product_code: str,
        adapter_params: Dict[str, Any],
        proxy: Optional[str] = None
    ) -> str:
        """
        调用 create.cgi 创建识别任务
        :param product_code: 产品编码(参照官方接口文档)
        :param adapter_params: 具体类型的参数,如 websiteURL, websiteKey
        :param proxy: 可选或必填的客户代理(不传则默认使用服务端代理池)
        """
        payload: Dict[str, Any] = {
            "product": product_code,
            "adapter": adapter_params
        }
        if proxy:
            payload["adapter"]["proxy"] = proxy

        resp = await self.client.post("/create.cgi", json=payload)
        resp.raise_for_status()
        data = resp.json()

        task_id = data.get("taskId") or data.get("task_id")
        if not task_id:
            raise NexCaptchaError(f"创建任务失败: {data}")
        return str(task_id)

    async def wait_for_result(
        self,
        task_id: str,
        poll_interval: float = 3.0,
        deadline: float = 120.0
    ) -> Dict[str, Any]:
        """
        调用 query.cgi 异步轮询任务结果
        处理任务状态:处理中、成功、失败、过期
        """
        start_time = time.monotonic()
        while (time.monotonic() - start_time) < deadline:
            resp = await self.client.get("/query.cgi", params={"taskId": task_id})
            resp.raise_for_status()
            data = resp.json()

            status = data.get("status")
            if status in ("success", "succeeded", "ready"):
                return data.get("solution") or data.get("data") or data
            elif status in ("failed", "expired"):
                # 任务失败或过期,系统会自动退回余额,客户端直接终止轮询
                raise NexCaptchaError(f"任务终止,状态: {status}, 详情: {data}")

            # 状态为 processing(处理中),非阻塞等待下一次查询
            await asyncio.sleep(poll_interval)

raise TimeoutError(f"等待验证码结果超时 ({deadline}s), taskId: {task_id}")注意:具体的请求头字段名与 JSON 响应键名请以 NexCaptcha 官方接口文档 中的最新示例为准。如果遇到任务长时间处于处理中状态,可按照《验证码任务一直 processing 怎么办:先分清“慢”和“卡”,再按顺序排查》进行定位。
四、 进阶:使用 WebSocket 推送替代高频轮询
在并发量较高的价格监控或批量回归测试场景中,成百上千个协程同时轮询 query.cgi 会产生大量无效的网络 I/O。NexCaptcha 原生支持 WebSocket 结果推送(关于轮询模式与推送模式的延迟对比,可参考《验证码API轮询和回调有什么区别:流程、延迟、部署条件与怎么选》)。
在 Python 中,我们可以利用 websockets 库维护一条长连接,当服务端完成识别后立即唤醒对应的 asyncio.Future:
import json
import asyncio
import websockets

async def listen_captcha_results(ws_url: str, api_key: str, pending_futures: dict):
    """
    WebSocket 结果监听协程示例
    当收到服务端推送的任务完成消息时,直接唤醒等待中的协程
    """
    extra_headers = {"X-API-Key": api_key}
    async with websockets.connect(ws_url, additional_headers=extra_headers) as ws:
        async for message in ws:
            event = json.loads(message)
            task_id = str(event.get("taskId", ""))
            status = event.get("status")

            if task_id in pending_futures:
                fut: asyncio.Future = pending_futures.pop(task_id)
                if not fut.done():
                    if status in ("success", "succeeded"):
                        fut.set_result(event.get("solution") or event)
                    elif status in ("failed", "expired"):
                        fut.set_exception(NexCaptchaError(f"任务 {status}: {event}"))
通过这种事件驱动模式,任务一旦识别完成即可在毫秒级内推回本地 Python 进程,大幅缩短 Token 在途损耗时间,留出更充裕的表单提交窗口。
五、 结合 Playwright 实现参数提取与 Token 注入
拿到 Token 只是第一步,真正的难点在于会话一致性。以 Cloudflare Turnstile 或 reCAPTCHA 为例,我们来看看如何在 playwright.async_api 中串联整个流程:
from playwright.async_api import async_playwright

async def solve_and_submit_with_playwright():
    captcha_client = AsyncNexCaptchaClient(api_key="YOUR_NEXCAPTCHA_API_KEY")

    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        context = await browser.new_context()
        page = await context.new_page()

        target_url = "https://example.com/login"
        await page.goto(target_url)

        # 1. 从页面 DOM 提取 sitekey
        sitekey = await page.locator("[data-sitekey]").get_attribute("data-sitekey")

        # 2. 创建识别任务(adapter 沿用 websiteURL / websiteKey 写法)
        task_id = await captcha_client.create_task(
            product_code="RecaptchaV2TaskProxyless",
            adapter_params={
                "websiteURL": target_url,
                "websiteKey": sitekey
            }
        )

        # 3. 异步等待返回 Token
        solution = await captcha_client.wait_for_result(task_id)
        token = solution.get("gRecaptchaResponse") or solution.get("token")

        # 4. 在客户自己的浏览器会话中注入 Token 并提交表单
        await page.evaluate(
            """(token) => {
                const el = document.querySelector('[name="g-recaptcha-response"]');
                if (el) el.value = token;
            }""",
            token
        )
        await page.click("button[type='submit']")

        await browser.close()
    await captcha_client.close()
代理与会话对齐要点
NexCaptcha 支持包括 reCAPTCHA v2/v3/企业版(含隐形)、Cloudflare Turnstile、极验 v3/v4、FunCaptcha/Arkose、DataDome、AWS WAF、Imperva、腾讯、网易易盾、阿里云等主流厂商,以及图形、滑块、点选、旋转、语音等通用类型(完整清单见官网验证码类型页,未列出的类型支持发样本询价)。
在接入不同类型时,务必注意代理配置:
- 无代理模式(Proxyless):如果不传代理,默认使用 NexCaptcha 服务端的代理池完成识别。
- 自带代理模式:部分强风控类型可以传、有的必须传客户自己的代理。此时请确保传给
adapter的代理出口 IP、以及浏览器环境的User-Agent与你本地 Playwright 发起后续业务请求时的会话保持一致。如果遇到 Token 返回后提交被目标站拒绝,可对照《验证码 token 返回后验证失败怎么排查:时效、参数、注入、评分与 IP 逐层定位》逐一核查。
六、 AI Agent 场景:免代码的 MCP 接入方案
如果你的 Python 项目正在构建基于大语言模型的 AI Agent(如自动化网页操作助手),甚至不需要手写上述 HTTP 封装代码。
NexCaptcha 提供了托管 MCP(Model Context Protocol)服务,无需本地部署,直接使用 API Key 鉴权。它内置了五个标准工具:查产品、查参数模型、创建任务、查任务、查余额(仅创建任务扣费,失败或过期自动退款)。无论是 Claude Code、Claude Desktop、Cursor、Codex、VS Code、Gemini CLI,还是你自己用 Python 编写的支持 Streamable HTTP 的 MCP 客户端,都可以直接配置接入。具体配置方法可查看 MCP 接入控制台 或阅读实战指南《让 AI Agent 像人一样工作:通过 MCP 标准实现自动化验证码识别》。
七、 从 2Captcha / Anti-Captcha 迁移到 NexCaptcha 的工程建议
对于正在比较打码平台或计划迁移的技术负责人与采购团队,需要明确:NexCaptcha 的接口不是传统的 createTask/getTaskResult 格式,因此现有代码不能仅靠替换域名完成迁移。
但得益于 adapter 内部字段沿用了 websiteURL、websiteKey 等通行命名,且接口文档为每种类型标注了对应的通行 Task Type 名称,迁移工作量主要集中在请求外层封装(create.cgi / query.cgi)与 Header 鉴权改写。
在Python项目中执行迁移时,建议采取以下三步策略:
- 抽象统一 Adapter 层:在业务代码中保留原有的参数字典构造逻辑,仅在最底层的
HttpClient发送层做路由分发。 - 按流量比例双跑(灰度切流):利用 Python 配置中心设置流量权重(例如先切 10% 流量到 NexCaptcha),对比两边的端到端耗时、接受率与有效成本(成本核算方法见《验证码API成功率怎么算:三层口径、公式与有效成本》)。
- 核对账单与全量切换:数据对齐、业务验证稳定后,再将流量全量切换过来。从特定平台迁移的细则也可参考《Anti-Captcha 迁移怎么做》与《CapSolver 替代方案怎么选》。
结语与合规提示
无论你是构建高并发的公开价格监控与 SEO 数据采集管线,还是维护企业级 CI/CD 自动化测试套件,一套基于 httpx 与 websockets 的轻量级 Python 异步打码封装都能显著提升系统的吞吐稳定性。
同时请务必遵守合规边界:NexCaptcha 严格禁止将服务用于撞库、盗号、批量注册、发送垃圾信息、规避封禁、支付欺诈、绕过付费墙或 DRM 等违规场景,一经发现违规密钥将直接停用且不予退款。
如果你准备开始联调,现在即可前往 NexCaptcha 注册页面 获取 API Key——注册即送测试额度,无需绑卡;账户余额永久不过期,无订阅费与最低消费限制,用量达到阈值还会自动触发阶梯折扣(支持支付宝、微信、USDT 及对公转账,详情见价格说明页)。在接入或迁移过程中有任何技术问题,欢迎随时联系官方 Telegram 客服 获取支持。


