
处理 SERP 采集中的验证码,可以按四步来做。第一步,判断响应是不是验证码拦截,例如 Google 的 /sorry/ 页面,而不是超时、同意弹窗或空结果。第二步,按代理成本决定处理方式:便宜的轮换 IP 直接隔离、换节点重试,固定会话或高成本代理再考虑原地识别。第三步,如果走识别,就要保证 data-s 参数、代理与 User-Agent、会话 Cookie 三项和触发拦截时一致,否则识别服务返回了 token,Google 也可能不接受。第四步,不管走哪条路,最后都要校验页面内容,以拿到的有效记录数来计算成功率,而不是看 HTTP 200 的数量。
另外,验证码出现说明请求已经被判定为可疑。规模化采集更应该先把触发率降下来,把识别当作兜底,不要让每个关键词都去等验证码。
本文讨论的是采集公开搜索结果、做排名监控这类允许的数据工作流。采集前请确认目标站条款、频率限制,以及你所在团队的合规要求。
先确认:这确实是验证码拦截
以 Google 为例,触发拦截时通常会出现以下情况:
- 请求被 302 重定向到
/sorry/index页面; - 页面提示 Our systems have detected unusual traffic from your computer network(检测到来自你所在网络的异常流量);
- 页面里嵌着 reCAPTCHA 复选框挑战(v2 或 Enterprise 形态),并带有服务端动态生成的参数,常见的有
data-s、q和回跳地址continue。
Google 帮助中心对这类提示的解释是,系统检测到你的网络中存在异常流量。常见诱因有并发过高、IP 信誉低(例如数据中心 IP),以及客户端特征异常。
代码里不要只用状态码判断,建议把响应分成几类:
| 现象 | 归类 | 后续处理 |
|---|---|---|
| 最终 URL 含 /sorry/,或页面出现 unusual traffic 文案 | 验证码拦截 | 进入下文的策略分流 |
| 页面是 cookie/隐私同意弹窗 | 同意墙 | 处理同意流程,不调用识别 |
| 200 但没有结果容器 | 稀疏页或结构变化 | 进入数据校验失败队列 |
| 连接超时、5xx | 网络或代理故障 | 按网络错误重试 |
分类准确与否,直接关系到成本。如果把同意墙或空页面当成验证码送去识别,钱花了,问题也不会解决。
第一道防线:把触发率降下来
对 SERP 采集来说,每次识别通常会让这个请求多出数秒到数十秒的等待,还会产生额外费用。所以第一步应该是减少拦截的出现:
- 控制并发和节奏。为单个 IP、单个会话设置请求频率上限,不要让同一出口在短时间内集中查询大量关键词。
- 代理质量与地区匹配。低信誉数据中心 IP 更容易被拦截。需要按城市或国家定位的排名监控,出口地区要和目标地区一致。
- 客户端特征一致。User-Agent、
sec-ch-ua等请求头、TLS 握手特征要和声明的浏览器对得上。用 Playwright、Selenium 时,也要检查浏览器有没有暴露明显的自动化特征。 - 会话复用要有度。一个会话 Cookie 可以连续用一段时间,但不要无限期地用下去。
这些措施做好后,验证码会降到少数请求才出现。此时再讨论识别方案,成本才能算得清楚。
被拦截后:换 IP 重试,还是原地识别
这是规模化团队最需要明确写进策略的一个分支。判断依据是这个 IP 或会话还值多少钱。
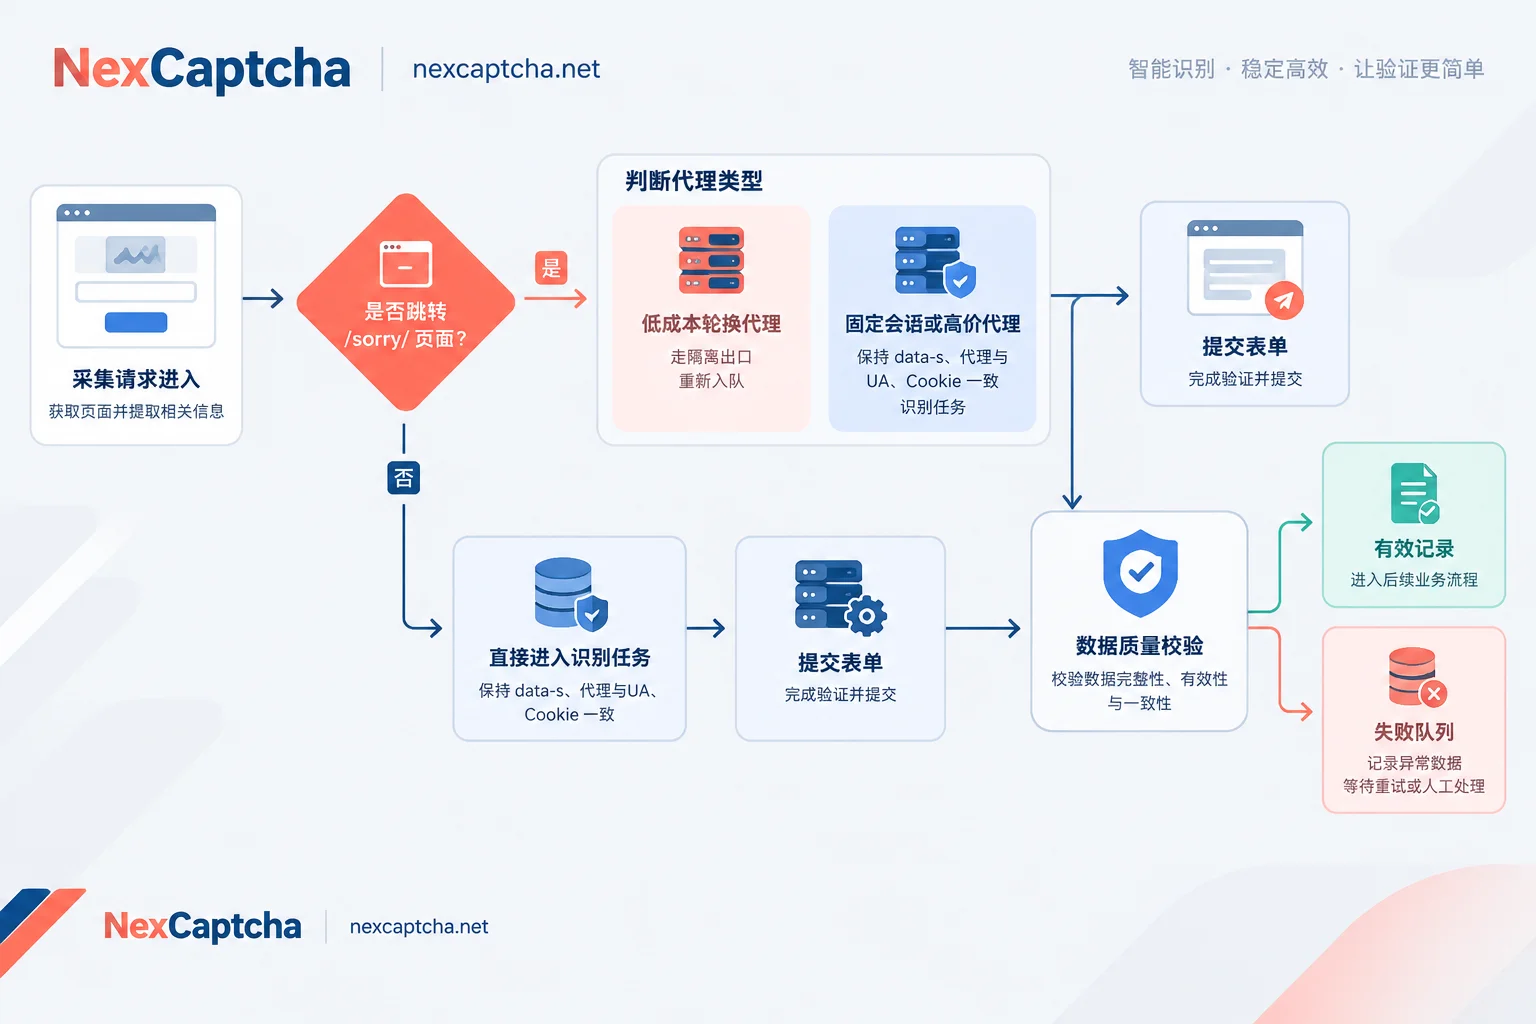
- 动态轮换代理(按请求或按流量计费,换 IP 成本很低):触发 sorry 后,把该出口标记隔离一段时间,关键词重新入队,换新节点重试。整体延迟和花费通常都低于原地识别。
- 固定会话(sticky session)、精细城市定位、独享或高价代理:这类出口不容易替换。可以调用识别 API 解开 sorry 页,保存恢复后的 Cookie,让这个会话继续采后面的关键词。
两种策略可以混合使用,但要设置上限。例如同一会话连续触发两次就放弃,同一关键词最多重试 N 次。这样可以避免某个坏出口反复消耗识别费用。
原地识别时,三项上下文必须一致
Google 会严格校验 sorry 页提交的 token 所处的上下文。识别服务返回 token 只说明这道题有了答案,Google 是否接受,取决于下面三项是否一致:
- 提交动态
data-s参数。它由服务端随页面生成,要从当次 HTML 中实时提取,不能缓存,也不能省略。 - 识别任务使用和爬虫相同的代理与 User-Agent。也就是说,你要把当前出口的代理信息交给识别服务。建议为此单独分配代理子账号或限定权限的凭据,不要直接交出主账号。
- 回提交表单时带上当前会话的 Cookie(如 NID 等)。提交 token 和
q、continue时要沿用同一个 Cookie jar,成功后用返回的 Cookie 继续请求continue地址。
下面是通用流程伪代码,任务类型名和字段名都是占位,要以你所用识别服务当前的官方文档为准:
# 伪代码:字段名为示意,不可直接运行
resp = fetch(serp_url, proxy=P, ua=UA, cookies=jar)

if is_sorry_page(resp):
    ctx = parse_sorry(resp.html)        # sitekey, data_s, q, continue
    if is_cheap_rotating(P):
        quarantine(P); requeue(keyword); stop

    task = create_task(
        type   = <支持 data-s 的 reCAPTCHA v2 类任务>,
        pageURL = resp.final_url,
        siteKey = ctx.sitekey,
        dataS   = ctx.data_s,
        proxy   = P, userAgent = UA)
    token = wait_result(task, timeout=T)   # 轮询或回调

    r2 = submit_sorry(ctx.q, ctx.continue, token,
                      proxy=P, ua=UA, cookies=jar)
    if is_sorry_page(r2):
        record("token_rejected"); quarantine(P); stop
    jar.update(r2.cookies)
    resp = fetch(ctx.continue, proxy=P, ua=UA, cookies=jar)

validate_serp(resp, keyword, region)等待结果时可以选择轮询或回调,两者的差别可参考验证码API轮询和回调有什么区别。超时阈值 T 不要设得太宽松。拿到 token 时页面上下文可能已经过期,与其提交,不如放弃,重新排队。具体做法见验证码API超时怎么处理。
token 返回了,页面还是 sorry:按这个顺序查
碰到这种情况,先不要直接认定是识别服务的问题,也不要认定一定是 IP 被封。按影响面从大到小逐项排查:
- data-s 是否来自当次页面。重试时有没有误用上一次的值?
- 识别任务的代理、UA 是否就是爬虫当时用的那一组。代理池轮换会不会让两边拿到不同的出口?
- Cookie 是否同一个 jar。并发任务之间有没有串号?
- token 是否超时。从拿到 token 到提交,中间隔了多久?
- sitekey 和页面 URL 是否填对,是否用了重定向后的最终地址。
- 以上都没问题仍然被拒,再考虑这个出口的信誉已经太低,按隔离策略处理。
更通用的逐层定位方法可参考验证码 token 返回后验证失败怎么排查。
拿到 200 也要校验:什么才算一条有效 SERP
解开验证码、拿到 HTTP 200,只说明请求通过了,结果不一定可用。常见的「假成功」有:
- 稀疏页(thin SERP):结果条数明显偏少,或缺少自然结果区块;
- 地区不匹配:出口 IP 跳到了别的国家或城市,排名数据对不上目标市场;
- 同意墙:欧盟等地区会先出现 consent 页面,页面里没有任何结果。
建议在解析层设置几道硬校验,任何一项不通过都不能计入成功:
- 核心结果容器存在,选择器能命中;
- 有效结果条数不低于设定阈值;
- 页面回显的查询词与请求的关键词一致;
- 页面语言、地区信号与任务设定一致。
校验失败的页面单独进入一个队列,把 HTML 留存下来。这样能区分是搜索引擎改了版、解析器出了问题,还是遇到了软拦截。
用哪些指标判断这套处理值不值
成功率要写清楚分母。建议至少跟踪四个指标:
- 触发率 = 遇到 sorry 的请求数 ÷ 总请求数,用来衡量第一道防线的效果;
- 识别返回率 = 返回 token 的任务数 ÷ 提交的识别任务数;
- 接受率 = 提交后不再是 sorry 的次数 ÷ 提交的 token 数;
- 有效记录率 = 通过数据校验的关键词数 ÷ 计划采集的关键词数。
成本也按有效记录来算。一个可以套用的估算框架(以下为假设,不是实测):
单条有效记录成本 =(代理费用 + 识别费用 + 重试产生的额外请求费用)÷ 有效记录数
假设触发率是 5%,识别的接受率只有 60%,那么剩下 40% 的识别费用就花在了被拒的 token 上。这时候应该先回头检查上下文一致性,或者对低价出口改用换 IP 策略,只靠多买识别额度解决不了问题。识别服务怎样计费、失败任务会不会扣费,会直接影响这个公式的结果,可参考验证码API按千次怎么计费。
接入识别服务前要确认的事
如果你决定在固定会话出口上做原地识别,选服务时重点核对以下几项:是否支持 reCAPTCHA v2/Enterprise 并能传 data-s,是否支持代理任务(用你的代理去解题),支持哪些回调或轮询方式,以及失败任务怎样计费。
NexCaptcha 提供统一的 REST 任务接口:用 createTask 提交任务,用 getTaskResult 获取结果,支持轮询和 webhook。官网列出的类型覆盖 reCAPTCHA v2/v3/Enterprise 等,自述的计费口径是按千次成功识别计费、失败退款,并提供测试额度。SERP sorry 页涉及 data-s 的任务具体用哪个任务类型、字段怎么命名,接入前请先向官方确认。确认后用一小批真实关键词做对照,看接受率和有效记录率,再决定是否放量。类型说明、价格和工程师联系方式都在 NexCaptcha 首页。


