
识别服务返回 token,只能说明你拿到了一个凭证,目标网站接不接受是另一回事。提交后验证失败,原因大多落在五处:
- token 过期或被重复提交,常见报错是
timeout-or-duplicate; - 生成 token 时用的上下文和目标页对不上,比如 sitekey、页面地址、action、rqdata;
- token 没有进入实际发出的请求,或者写进去了但没有触发组件回调;
- reCAPTCHA v3/Enterprise 校验通过,但分数没达到业务阈值;
- 生成 token 和提交表单时的 IP 或会话环境不一致。
所以第一步不是换代理或换平台,而是找出失败发生在哪一层,再对照错误码查具体原因。
第一步:确定失败在哪一层
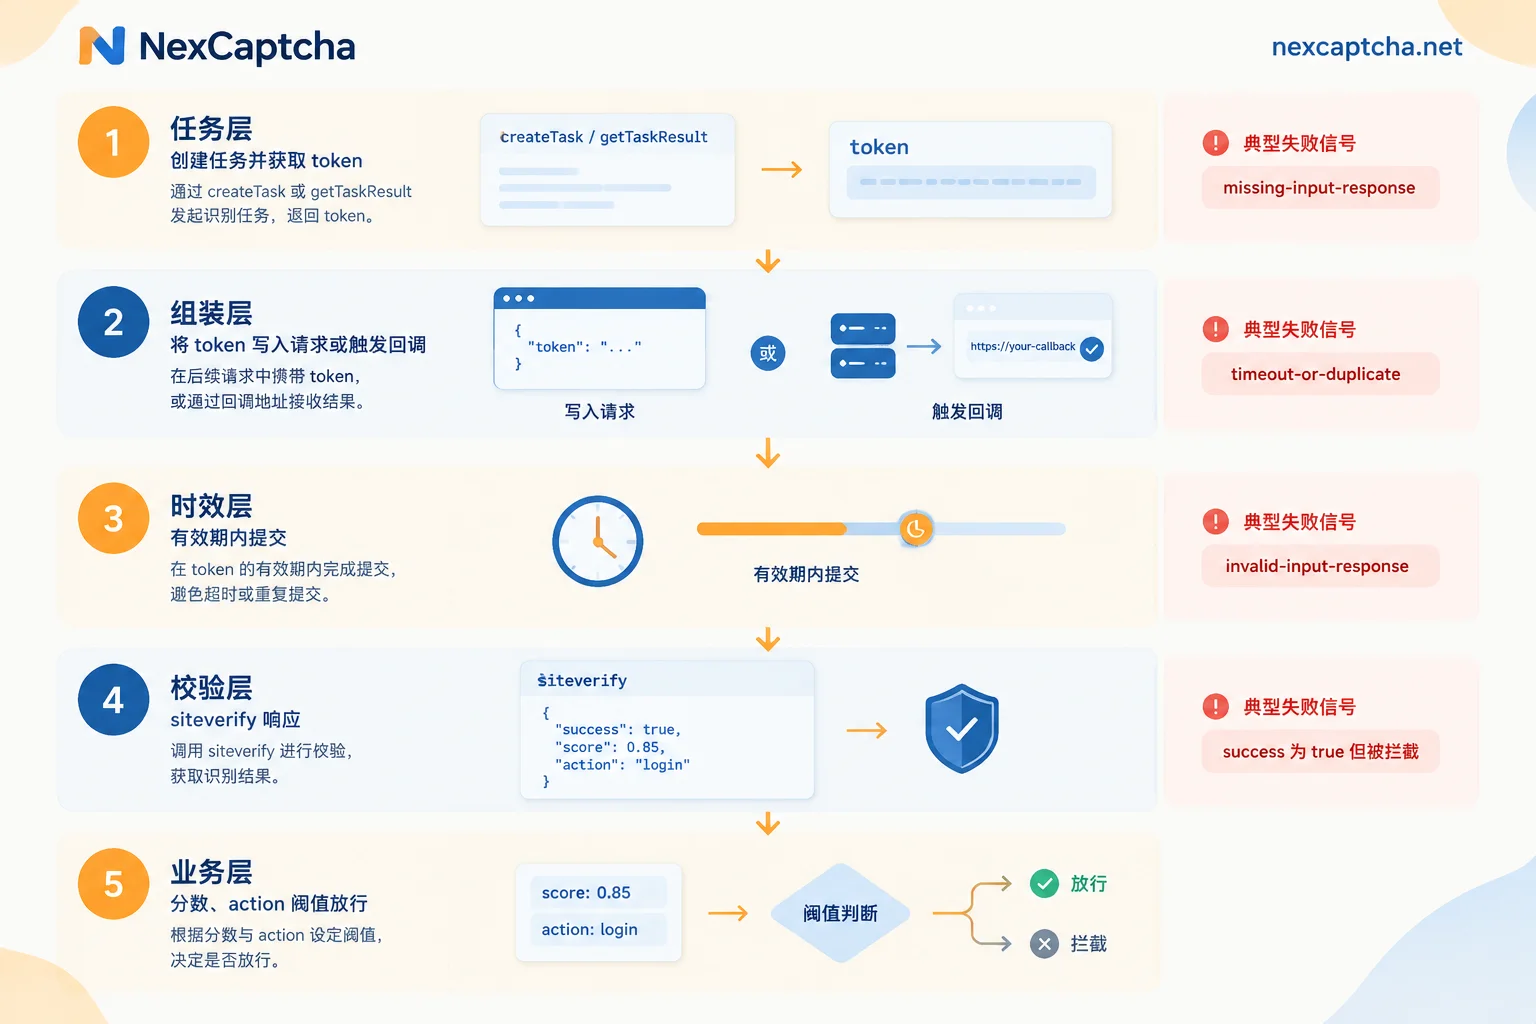
从拿到 token 到业务放行,可以拆成五层,逐层确认:
- 任务层:识别任务是否真的完成并返回了 token。以 NexCaptcha 为例,通过
createTask提交任务,再用getTaskResult轮询(或用 webhook)拿结果。这一层失败表现为任务报错或超时,不属于本文讨论的情况。 - 组装层:token 有没有出现在真正发出的请求里。可以用浏览器 Network 面板、HAR 文件或 HTTP 客户端日志确认。
- 时效层:从拿到 token 到提交,中间隔了多久。
- 校验层:目标后端调用 siteverify 时,验证码厂商返回了什么。
- 业务层:siteverify 返回成功之后,业务规则(分数阈值、action、hostname)是否放行。
如果后端是你自己的系统,或者是获授权的测试环境,直接把 siteverify 的完整响应记进日志,这是最直接的证据。如果你只能看到前端的“请重试”之类提示,就只能靠控制变量来推断:一次只改一个条件,看结果是否变化。
第二步:按错误码缩小范围
reCAPTCHA 的 siteverify 会返回 error-codes。hCaptcha、Turnstile 的校验接口也有类似字段,具体码值以各自文档为准。常见的几种:
| 现象 / 错误码 | 最可能的层 | 先查什么 |
|---|---|---|
missing-input-response 或请求里 token 字段为空 | 组装层 | 隐藏字段是否写入、框架状态是否更新、回调是否触发 |
timeout-or-duplicate | 时效层 | 拿到 token 到提交的耗时;重试时是否复用了旧 token |
invalid-input-response | 任务参数 / 组装层 | sitekey、websiteURL、任务类型、action/rqdata;token 是否被截断 |
success: true 但仍被拦截 | 业务层 | v3 分数、action、hostname 是否符合后端规则 |
| 有时成功有时失败,换网络后表现不同 | 环境一致性 | 代理模式、出口 IP、Cookie 和 UA 是否一致 |
下面按原因逐一说明。
原因一:token 过期,或同一个 token 提交了两次
验证码 token 有时效,而且只能用一次。Google reCAPTCHA 和 hCaptcha 的 response token 有效期通常在 2 分钟左右,Cloudflare Turnstile 最长 300 秒。超出时间窗口,或者同一个 token 已经被校验过一次,siteverify 会返回 timeout-or-duplicate。
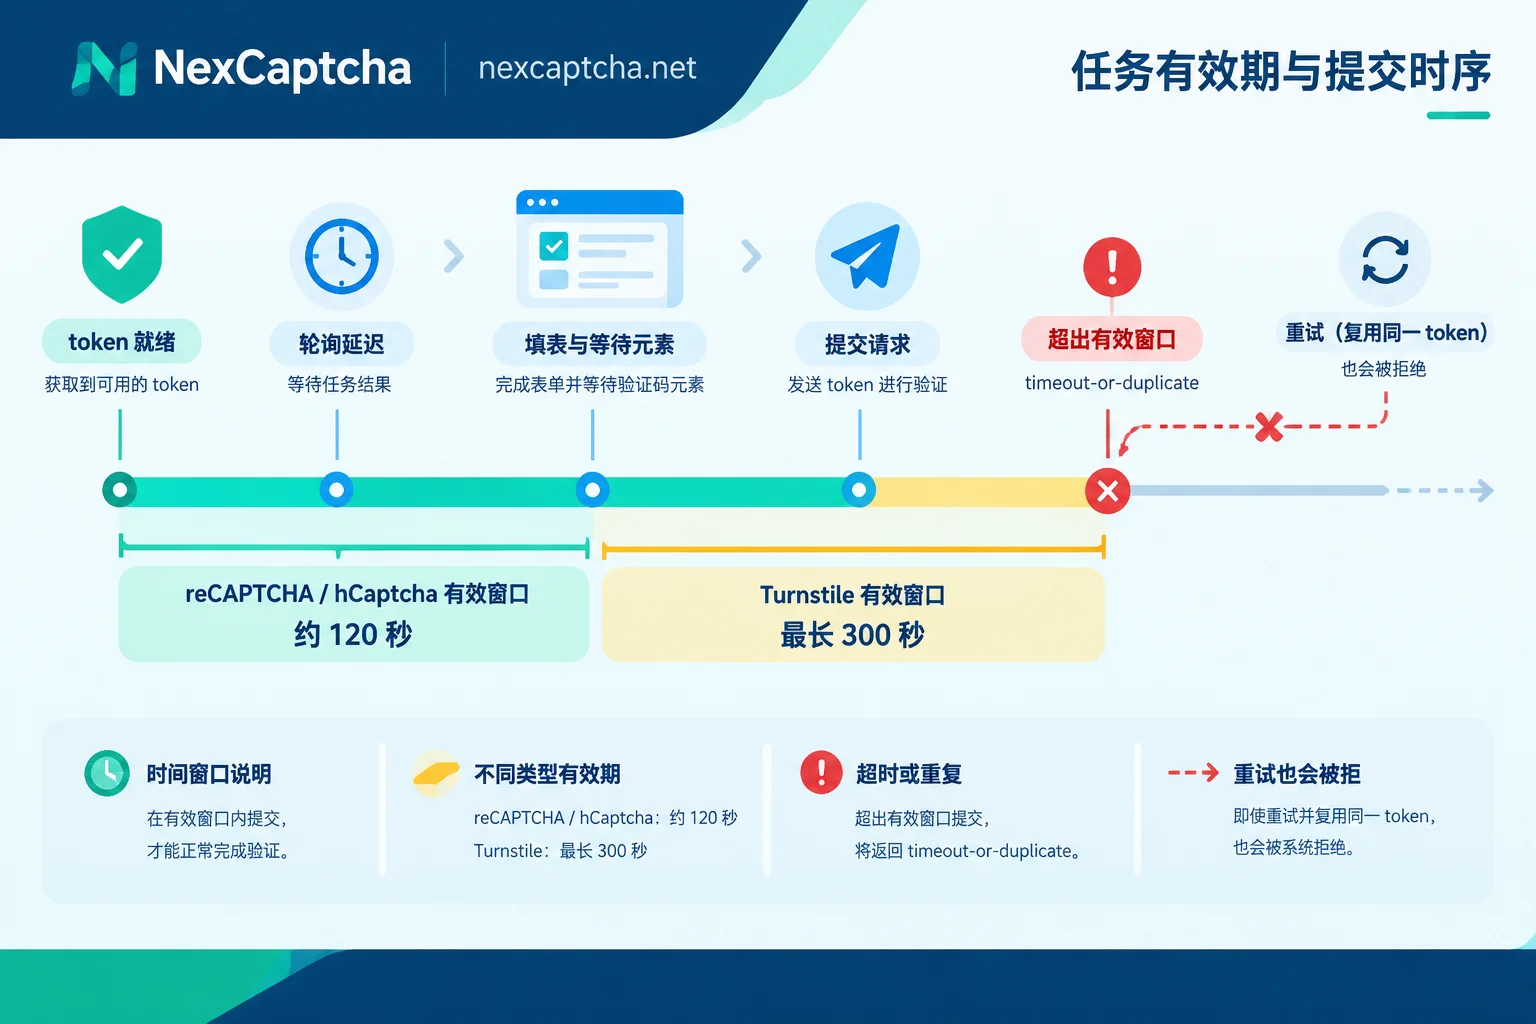
自动化流程里常见的触发情况:
- 轮询间隔过长:任务其实早就完成了,脚本隔很久才去取结果,有效期已经消耗了一部分。
- 拿 token 太早:先取到 token,再填表、等元素、翻页,最后才提交。
- 预取 token 池:为了省时间提前批量生成,用的时候已经接近或超过有效期。
- 重试逻辑复用旧 token:第一次提交时网络超时,其实后端已经校验过了,重试又发了同一个 token。
- 拿到 token 后页面刷新:组件重新渲染,旧 token 和新挑战对不上。
对应的处理方法:把创建识别任务放到提交前的最后一步;每次重试都创建新任务;在日志里分别记录“结果就绪时间”和“提交时间”,算出实际间隔。如果轮询本身占了大量时间,可以评估改用回调,见 验证码API轮询和回调有什么区别。
原因二:任务参数和目标页上下文不一致
token 跟生成它时的上下文绑定在一起。参数填错了,任务一样能返回 token,但后端校验不会通过,常见报错是 invalid-input-response,也可能被直接拒收。逐项核对:
- sitekey:从当前实际渲染出来的组件里读取,不要一直沿用硬编码的值。同一站点的测试环境和生产环境、不同页面,sitekey 都可能不同;一个页面上也可能有多个组件。
- websiteURL:填加载验证码组件的那个页面地址,不是表单提交的 API 地址。
- 任务类型:reCAPTCHA v2、v3、Enterprise 的任务类型不同,选错类型拿到的 token 通常无法通过校验。版本区别见 reCAPTCHA v2 和 v3 区别。
- reCAPTCHA v3 / Enterprise 的 action:客户端 execute 时使用的 action 必须和后端期望的一致。去页面脚本里找
execute调用时传入的 action 值。 - Turnstile 的 action / cdata:如果站点在组件上配置了这两个值,并在服务端做了校验,就需要一并传入。
- hCaptcha Enterprise 的 rqdata:这个值是动态的,和当前挑战绑定,每次都要重新获取,不能缓存复用。接入细节见 hCaptcha 识别 API 怎么接入。
另外要确认页面上出现的是 Turnstile 组件,还是 Cloudflare 的整页 Challenge。两者的凭证和处理方式不同,用 Turnstile 的 token 应付整页 Challenge 不会成功,区别见 Turnstile 和 5 秒盾有什么区别。
原因三:token 没进入请求,或没有触发回调
这一类在浏览器自动化里最常见。很多脚本只是把 token 写进隐藏字段:reCAPTCHA 是 g-recaptcha-response,Turnstile 是 cf-turnstile-response,hCaptcha 通常是 h-captcha-response。但在 React、Vue 这类单页应用里,直接改 DOM 的值不会更新应用内部的表单状态,最后发给后端的 payload 里 token 仍然是空的。
还有一种情况:网站通过回调函数控制提交。组件上配置了 data-callback,或者在渲染时传入了 callback,只有回调被调用,提交按钮才会启用,或者表单才会发出。这时写完 token 后,还需要用这个 token 主动调用页面的回调函数。有些做法是从 ___grecaptcha_cfg.clients 里找 reCAPTCHA 的回调,但这是 Google 的内部结构,随时可能变化。更稳妥的做法是从页面脚本或组件属性里找到实际的回调名。
判断方法:不要只看 DOM,要看实际发出去的请求。在 Playwright 或 Puppeteer 里监听提交请求,检查请求体里有没有 token 字段、长度是否正常。如果这里没有,问题就在组装层,跟识别服务和 IP 都没有关系。
原因四:v3 / Enterprise 校验成功,但分数不够
reCAPTCHA v3 和 Enterprise 属于评分型验证码。siteverify 返回 success: true,只代表 token 格式合法、仍在有效期内。响应里还会带一个 0.0 到 1.0 的 score,业务后端会自己设定阈值。比如某站点要求 0.7 以上,而这次只拿到 0.3,就会在业务层被拦截,前端看到的往往只是一个笼统的“验证失败”。
这一层的结果,部分不在识别服务的控制范围内。能做的有三件事:确认 action 正确;保持提交环境一致(见下一节);如果所用服务支持为评分类任务指定相关参数,按它当前的文档配置。如果你控制后端,可以把 score、action、hostname 都记进日志,判断问题是分数不够还是字段不匹配。
原因五:IP 和会话环境不一致
Google 和 hCaptcha 的 siteverify 都支持一个可选参数 remoteip。有些站点会核对生成 token 的客户端 IP 和提交请求的 IP,WAF 也可能关注这类不一致。使用不带代理的任务(Proxyless)时,token 在识别服务的节点上生成,提交却来自你的本地出口或另一个代理,被拒收的概率会上升。
如果怀疑是这个原因,可以改用带代理的任务类型,让生成 token 和提交请求走同一个出口,同时保持 Cookie、UA 等会话信息一致。但要注意,不是所有失败都和 IP 有关:报 timeout-or-duplicate 时换代理没有用;请求里 token 为空时,换 IP 也解决不了。
排障时建议记录的字段
每次失败都能从日志还原现场,排查会快很多。建议记录:
- 任务 ID、任务类型、sitekey、websiteURL;action、rqdata 是否传入;代理模式和出口 IP
- 任务创建时间、结果就绪时间、实际提交时间
- 提交请求里 token 字段是否存在、长度多少(只记长度,不记完整值)
- 目标站返回的状态码、错误码或页面提示;能拿到时附上 siteverify 原始响应
token 原文、Cookie 和 API 密钥(如 NexCaptcha 请求体中的 clientKey)都不要写进日志或截图。
识别服务负责哪一段
在这条链路里,NexCaptcha 负责任务层:按你提交的任务类型和参数生成 token,通过 getTaskResult 轮询或 webhook 交付结果。后面的组装、时效控制、提交和环境一致性,由你的脚本负责。所以接入时要先确认两件事:目标站点对应的任务类型(例如 Enterprise 和普通版的区别)在官网列出的支持范围内;按目标站点的情况选择带代理还是不带代理的任务。官网说明按千次成功识别计费、失败退款。至于“token 已返回、但被目标站拒收”算不算失败,应以平台的计费说明为准,相关口径可参考 验证码API按千次怎么计费。
如果你测试的是自己的系统,用验证码厂商提供的官方测试密钥就能覆盖大部分 CI 回归,不必每次都走真实识别,做法见 Playwright 验证码测试怎么做。需要在获授权的真实环境里联调时,可以在 NexCaptcha 首页 查看支持的类型,并通过工程师联系入口确认具体任务参数。


