
在 Selenium 里做验证码测试,第一步不是让脚本学会“过验证码”,而是先按测试层级决定验证码该不该出现:
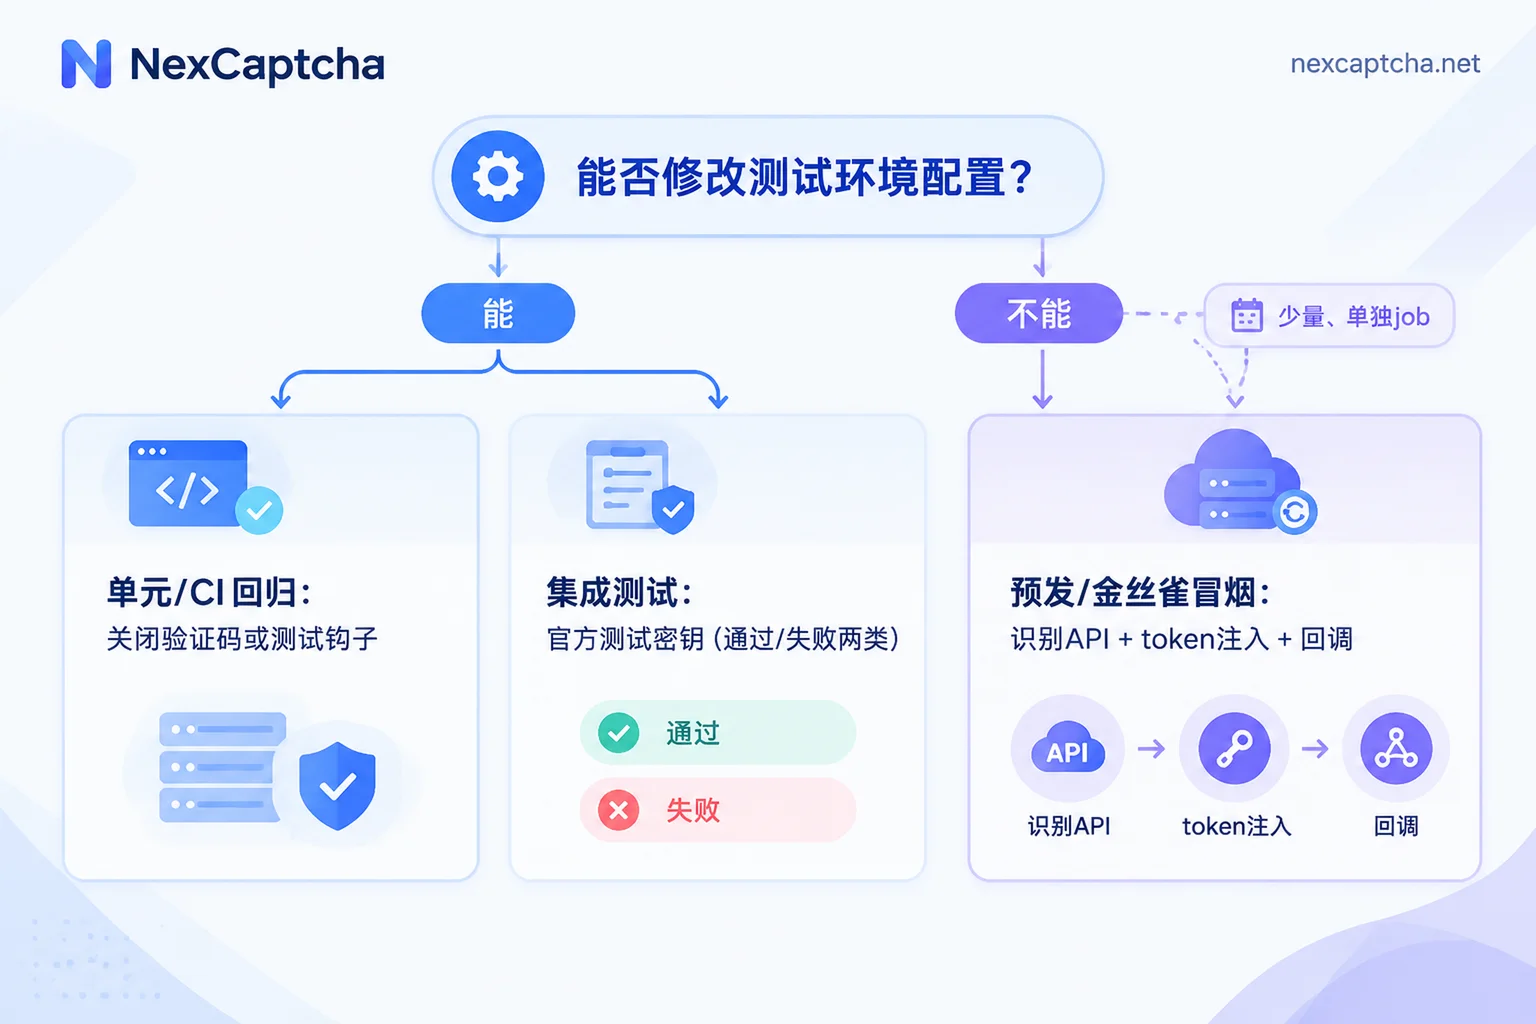
- 单元测试和日常 CI 回归:在测试环境关闭验证码,或者换成验证码厂商的官方测试密钥,让每次运行结果都可预期。
- 验证“前端组件 → token → 服务端校验”这条集成链路:继续使用测试密钥,再用“必定失败”类的测试密钥覆盖错误分支。
- 预发布或金丝雀冒烟,必须面对真实验证码且无法改密钥:这时才考虑由 Selenium 提取页面参数,调用识别 API 获取 token,注入页面并触发回调。这类用例只保留少量,用作冒烟检查。
下文按这三层展开。前提是被测系统属于你自己的团队,或者你已经拿到明确授权。
先确认两件事:验证码类型,以及你能改什么
动手前先回答两个问题,它们决定后面走哪条路。
- 页面用的是哪种验证码。 reCAPTCHA v2 复选框、v3 打分、Enterprise、Cloudflare Turnstile 组件、hCaptcha 和自研图形验证码,测试方法各不相同。有的只需要往隐藏域写 token,有的必须调用前端回调函数才算完成。如果拿不准版本,可以参考reCAPTCHA 识别 API 的版本判断方法。
- 你对当前环境有没有配置权限。 能改测试环境的 sitekey 和 secret,或者能加环境开关,就优先用第一、二层方案。只有在第三方托管、外部预发这类改不了配置的环境里,才需要第三层。
第一层:在测试环境关闭验证码或留测试钩子
Selenium 官方文档把“在测试中处理 CAPTCHA”列为不推荐的做法。验证码的设计目的就是阻止自动化,常规功能测试不应该去硬破解它。官方给出两种思路:在测试环境直接禁用验证码,或者增加一个测试专用的绕过钩子。
落地时注意三点:
- 开关放在服务端配置里,并按环境区分。 生产配置中根本不存在这个开关。不要靠前端参数或请求头来控制,否则外部请求也可能触发绕过。
- 限制钩子的使用范围。 比如只对测试网络、专用测试账号生效,并在发布检查里确认生产环境没有开启。
- 认清这一层测的是什么。 它验证的是注册、登录、下单等业务逻辑,不能证明验证码集成本身是正确的。
第二层:用官方测试密钥测集成链路
想确认“组件能加载、token 能产出、服务端能校验”,又希望结果稳定,可以使用验证码厂商提供的测试密钥。下表列出几家厂商公开的测试密钥:
| 厂商 | 测试 Site Key | 行为 |
|---|---|---|
| reCAPTCHA v2 | 6LeIxAcTAAAAAJcZVRqyHh71UMIEGNQ_MXjiZKhI(Secret:6LeIxAcTAAAAAGG-vFI1TnRWxMZNFuojJ4WifJWe) | 校验请求总是通过,组件会显示测试用途提示 |
| Cloudflare Turnstile | 1x00000000000000000000AA | 可见组件,总是通过 |
| Cloudflare Turnstile | 2x00000000000000000000AB | 可见组件,总是失败 |
| Cloudflare Turnstile | 3x00000000000000000000FF | 强制出现交互式挑战 |
| hCaptcha | 10000000-ffff-ffff-ffff-000000000001(Secret:0x0000000000000000000000000000000000000000) | 无需交互即返回测试 token,可通过服务端校验 |
使用时有几点要注意:
- 前端 sitekey 和服务端 secret 要成对替换。 只换前端 sitekey 时,真实 secret 会拒绝测试 token。Turnstile 的测试 secret 也分“通过”和“失败”等多种,组合方式以 Cloudflare 的测试文档为准。
- 上表中 reCAPTCHA 的测试密钥对应 v2。 v3 和 Enterprise 的测试环境配置,请按 Google 当前文档单独确认,不要直接套用。
- 防止测试密钥流入生产。 生产环境误用测试密钥,验证码就形同虚设。建议在部署检查中断言:生产配置的 sitekey 不在测试密钥列表里。
以 Turnstile“总是通过”的测试 sitekey 为例,Selenium 用例只需要等 token 写入隐藏域,再提交表单:
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait

driver = webdriver.Chrome()
# 自有测试环境,前后端已配置 Turnstile 测试密钥
driver.get('https://staging.example.test/signup')

driver.find_element(By.NAME, 'email').send_keys('[email protected]')

# 测试 sitekey 会自动产出 token,等隐藏域有值再提交
WebDriverWait(driver, 15).until(
    lambda d: d.find_element(By.NAME, 'cf-turnstile-response').get_attribute('value')
)
driver.find_element(By.CSS_SELECTOR, 'button[type=submit]').click()

# 断言业务结果,而不是只断言“有 token”
WebDriverWait(driver, 15).until(lambda d: '注册成功' in d.page_source)
有了“必定失败”的密钥,就能把常被忽略的分支一起覆盖:
- 校验失败时,页面是否给出可理解的提示,提交按钮状态是否正确;
- 服务端拒绝后,是否没有写入数据,没有发送邮件;
- 用户重试时,组件能否重置,旧 token 是否被二次提交;
- 出现交互式挑战时,页面布局和超时提示是否正常。这类用例检查的是页面表现,通常不期望自动通过。
第三层:必须对真实验证码做冒烟时
有些场景改不了密钥,例如外部托管的预发环境、第三方登录页,或者你需要确认生产防护配置确实生效。这时 Selenium 要和外部识别服务配合,形成闭环:
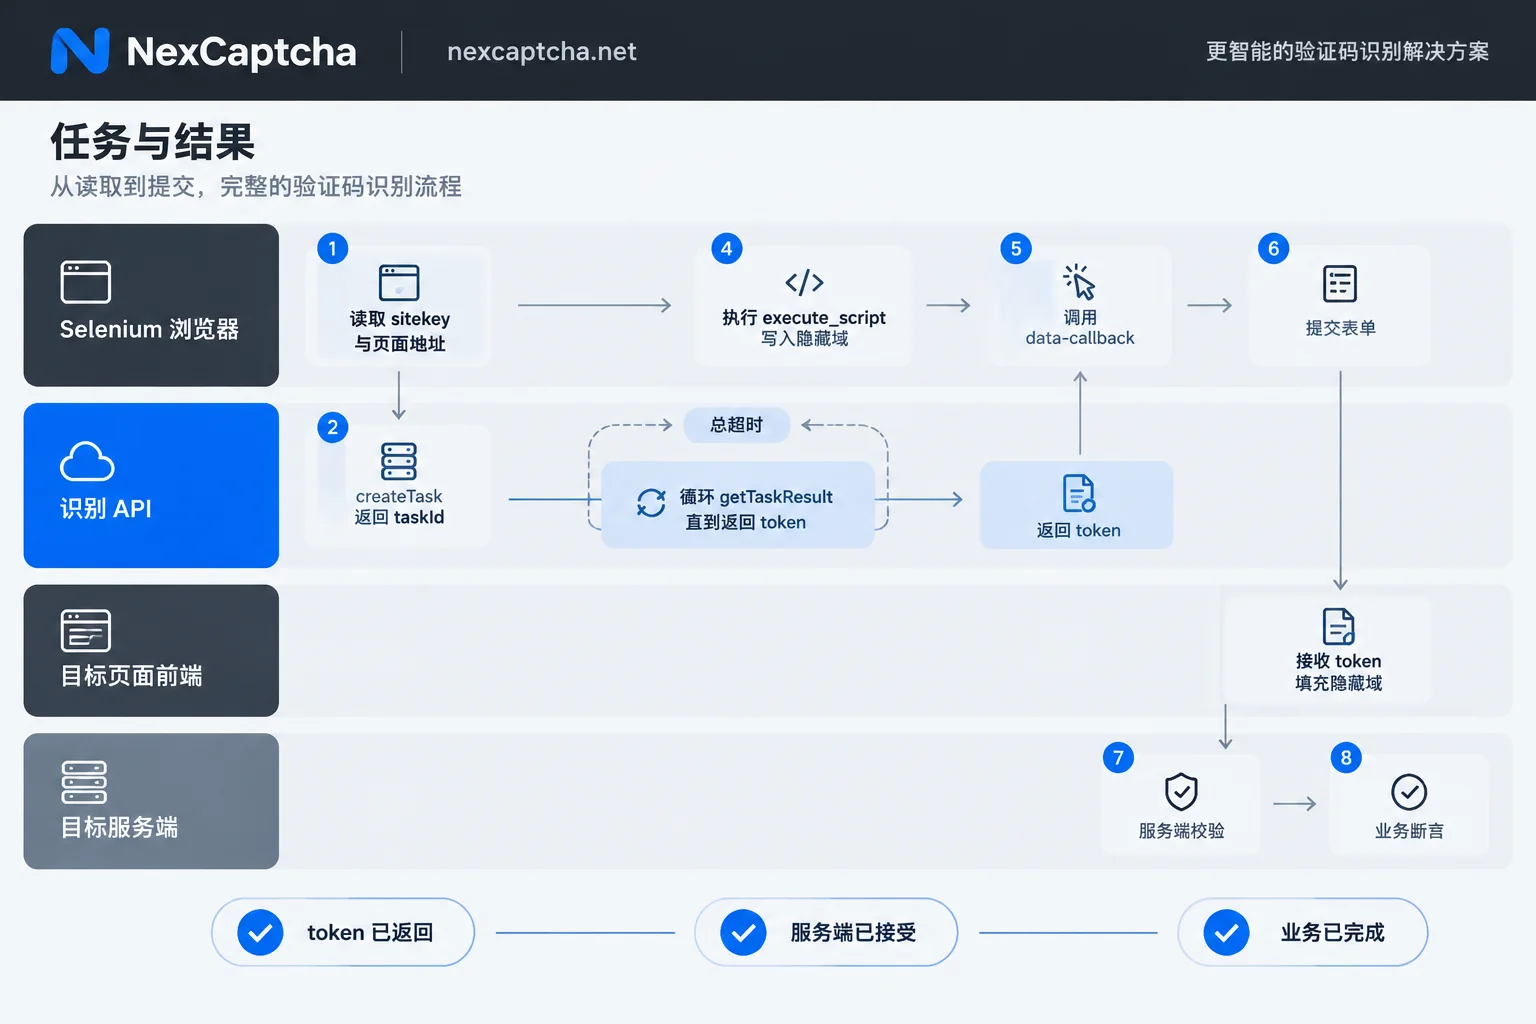
下面的伪代码只用来说明结构,不能直接运行。任务类型名和字段名请以所用服务当前的接口说明为准:
# 伪代码:结构示意
site_key = 用 Selenium 读取验证码容器的 data-sitekey
page_url = driver.current_url

task_id = 调用 createTask
          clientKey 从 CI 密钥管理读取,不写进代码
          task = { 类型: <按验证码类型填写>, 页面地址: page_url, sitekey: site_key }

循环调用 getTaskResult(task_id),设置轮询间隔和总超时
  仍在处理 → 等待后继续
  失败或超时 → 记录 taskId 与耗时,标记为“依赖失败”
  返回 token → 结束循环

driver.execute_script 把 token 写入对应隐藏域
  (如 g-recaptcha-response、cf-turnstile-response)
页面若绑定了 data-callback → 用同一个 token 调用该回调
提交表单 → 断言业务结果(跳转、提示、后端记录)
这一层最容易出问题的几个地方:
- 会话一致。 读参数、拿 token、提交表单,要在同一个 driver 会话、同一个页面里完成。不要跨用例或跨页面复用 token。
- 时效与超时。 token 有有效期,拿到后应尽快提交。轮询一定要设总超时,避免用例无限挂起。任务长时间停在处理中的排查方法,可以参考验证码任务一直 processing 怎么办和验证码 API 超时怎么处理。
- 只写隐藏域往往不够。 在 React、Vue 等前端框架里,组件状态通常靠验证码回调更新。只改 DOM 的 value,提交按钮可能仍然不可用,所以需要显式调用页面注册的回调函数。
- 分清组件和整页拦截。 Turnstile 组件和 Cloudflare 整页 Challenge、DataDome 拦截不是一回事。Selenium 默认会暴露
navigator.webdriver等自动化特征,在高防护配置下可能直接被整页拦截,这时往页面里塞 token 解决不了问题。对自有系统,更合理的做法是和安全团队约定测试流量规则或白名单,而不是在用例里伪装浏览器,因为伪装之后测出来的结果也代表不了真实用户。 - 断言分三层。 识别服务返回了 token,不等于目标服务端校验通过;校验通过,也不等于业务流程完成。用例日志里应分别记录这三步,失败时才能判断是依赖问题还是业务缺陷。token 返回后仍被拒绝的情况,可按时效、参数、注入、评分与 IP 逐层定位;统计成功率时的分母怎么选,可参考验证码 API 成功率的三层口径。
放进 CI 的节奏
一个比较稳妥的安排是:
- 每次提交:只跑第一、二层,结果可预期,不依赖外部服务;
- 每日或发布前:单独建一个 job,跑少量第三层冒烟用例。这个 job 与主回归分开,失败时先告警并保留 taskId、各阶段耗时和截图,再决定是否阻塞发布;
- 密钥管理:识别服务的 clientKey 放进 CI 的密钥管理。日志、截图和测试报告里都不要输出 key 或完整 token;
- 控制调用量:识别服务通常按任务计费,冒烟用例的数量和重试次数要设上限,避免某次回归异常时批量消耗额度。
第三层选识别服务时看什么
只有确实需要第三层时,才需要选识别服务。重点看四件事:
- 是否覆盖你页面上的验证码类型和版本;
- 是否提供任务式接口,并同时支持轮询和回调;
- 失败任务是否计费;
- 延迟看 P95 等分位数,不只看平均值。
NexCaptcha 官网介绍了统一的 REST 任务接口,包括 createTask、getTaskResult、getBalance,支持轮询和 webhook。覆盖类型包括 reCAPTCHA v2/v3/Enterprise、hCaptcha、Cloudflare Turnstile 等。官网自述按千次成功识别计费、失败退款,并提供测试额度。需要注意,类型在支持列表里,不代表在你的页面和会话中一定会被接受。建议先在自己的预发环境用几条冒烟用例跑通三层断言,再决定是否纳入定期流程。具体类型、价格和接入问题,可以在 NexCaptcha 官网 查看或联系工程师确认。


