
处理验证码API超时,第一步是判断超时发生在哪一层。“超时”这个报错背后至少有四个互相独立的时钟:单次HTTP请求的超时、从提交任务到拿到结果的轮询总预算、目标站点给Token设定的有效期,以及你的自动化脚本自己的等待上限。它们的成因不同,处理方式也不同。如果用同一套“超时就重试”的逻辑去处理,常见后果是重复建任务、多扣费、触发限流,或者把一个本来就过期的Token提交给目标站点。
下面按“先定位、再分别处理”的顺序展开。
先判断是哪一种超时
| 超时类型 | 常见表现 | 问题所在 | 首要处理 |
|---|---|---|---|
| HTTP 请求超时 | 连接超时、读取超时、502/504 | 单次网络请求没有按时完成 | 有限重试,并区分是否已经拿到任务ID |
| 任务轮询超时 | 状态一直是处理中,超出等待预算 | 求解慢、排队,或参数本身不可解 | 设总预算,按错误码决定重试还是中止 |
| Token 过期 | API 返回了结果,目标站点却拒绝 | 结果拿到后用得太晚,或被重复使用 | 拿到后立即注入并提交 |
| 客户端挂起 | 脚本卡住,或出现未处理的 Promise Timeout | 等待没有上限,页面上下文已经失效 | 外层总超时,加上资源清理 |
看日志可以快速归类:
- 没有拿到任务ID就报错,是HTTP层的问题,集中在创建任务这一步。
- 有任务ID,但一直等不到完成状态,是轮询超时。
- API返回了成功结果,目标站点仍然报错,大概率与Token时效或提交方式有关。
- 程序没有任何报错却停在某一步,先查客户端的等待逻辑。
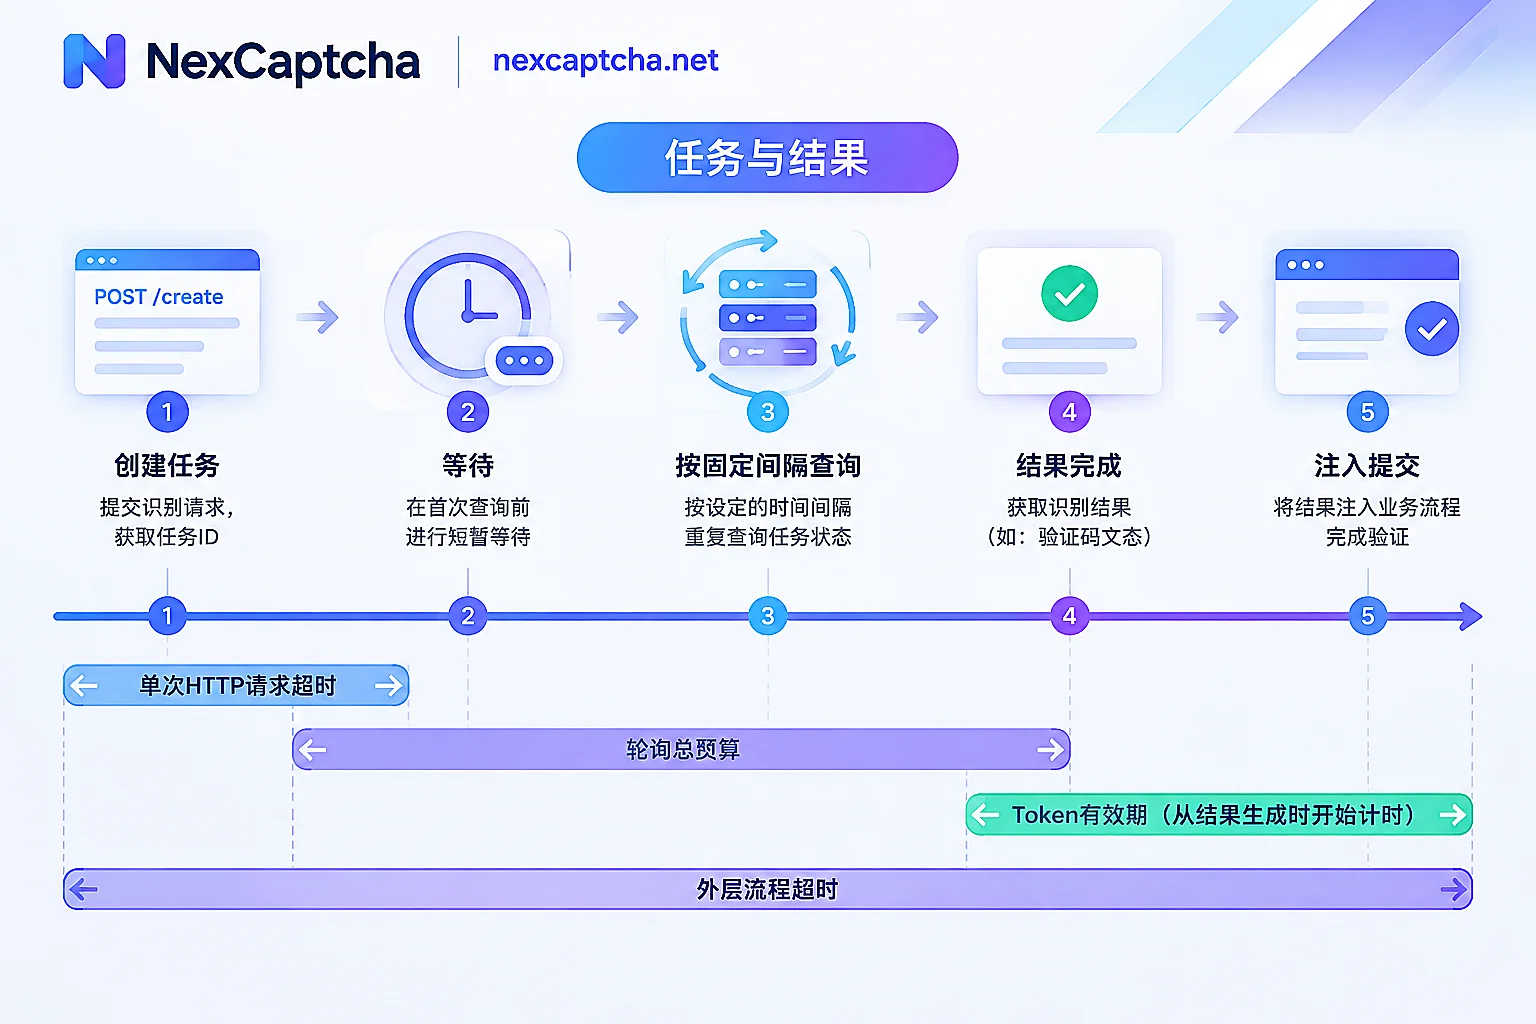
HTTP 请求超时:重试前先确认任务是否已创建
连接超时和读取超时要分开设置。连接超时可以短一些,用来快速发现网络不通。读取超时要给服务端处理留出余量。不要用一个很大的全局超时同时覆盖两者。
最需要小心的是创建任务(createTask)这一步超时。请求可能已经到达服务端,任务也已经创建,只是响应在回程中丢失。这时直接重发,就会多出一个重复任务。在按成功识别计费的平台上,如果两个任务都被解出,两个都可能计费。比较稳妥的做法是:
- 创建任务的重试次数设得很低(例如1到2次),每次重试都写入日志。
- 监控创建阶段的超时率。如果它持续偏高,应该排查网络链路或出口,而不是靠加大重试次数掩盖问题。
- 一旦拿到任务ID,后续的网络错误只重试结果查询(getTaskResult),不要因为查询失败就重新建任务。
任务轮询超时:设好初始延迟、间隔和总预算
求解需要时间,查询得再频繁也不会让结果更快出来。查询过密反而可能触发识别平台的速率限制,严重时出口IP会被临时限制。多家识别服务商的公开资料给出的经验值大致如下,可作为起点,再按自己的数据调整:
- 图形类识别通常几秒内返回,交互式验证码(如 reCAPTCHA v2/Enterprise、Cloudflare Turnstile)常见需要十几到四十秒。
- 提交任务后先等1到3秒再发第一次查询,之后每3到5秒查一次。
- 轮询总预算一般设在60到120秒。超过预算就主动结束,判定为超时,不要无限等待。
预算最好按验证码类型分别设置。图形任务给一个短预算,token类任务给长一些。共用一个120秒,会让图形任务的故障被拖很久才暴露。
轮询超时之后不要立刻用原参数再建一个任务。等了这么久,页面上的验证码组件、会话状态或参数可能已经变化。更合理的顺序是:先判断页面是否还有效,必要时重新加载页面、重新读取参数,再新建任务。
用错误码决定重试还是止损
超时只是一个表现,平台返回的错误码和任务状态才说明原因。大致可以分成两类:
- 可以等待后重试的:排队满载、并发超限、请求过于频繁。以2Captcha文档为例,ERROR_NO_SLOT_AVAILABLE 表示暂时没有空位,应采用指数退避,即每次等待时间逐步加长后再试。
- 不应原样重试的:任务本身不可解,例如2Captcha的 ERROR_CAPTCHA_UNSOLVABLE。它常见的原因是 sitekey 填错、页面地址不对、任务类型选错,或者运行环境与目标页面不符。参数不变就重试,大概率还是失败,同时还在消耗时间和配额。正确做法是中止流程,回头核对参数。
不同平台的错误码名称和含义不一样。重试规则要按你实际使用的平台文档逐条映射,不能拿别家的错误码直接套用。
Token 过期:问题常出在拿到结果之后
目标站点对Token有自己的时效规则,识别服务无法延长它。以 Google reCAPTCHA 为例,官方文档说明每个响应Token只有2分钟有效期,而且只能校验一次。过期或重复使用时,校验会返回 timeout-or-duplicate。
要注意,这个时钟从Token生成时开始计算,不是从你的程序拿到它时开始。以下几段时间都会消耗有效期:
- 轮询间隔造成的延迟:结果已经生成,但要等下一次查询才能取到。
- 拿到Token后,程序又去做数据抓取、等待渲染或其他慢操作。
- 提交失败后重复使用同一个Token。
处理原则是把验证码这一步尽量安排在提交动作的紧前面。拿到结果后立即注入并提交,中间不要插入其他耗时操作。提交失败时重新获取Token,不要复用旧的。如果API已经返回成功、目标站点仍然拒绝,可以参考 验证码 token 返回后验证失败怎么排查,按时效、参数、注入方式、评分和IP逐项排查。
自动化客户端挂起:给整条流程加外层超时
在 Playwright、Puppeteer、Selenium 或 Node.js 异步代码中,常见的问题是等待本身没有上限,或者超时后没有做清理。例如 Node.js 中一个带超时的 Promise 被 reject,却没有任何 catch 处理,就会出现未处理的 Promise Timeout 报错,留下的定时器和页面也没有关闭。
建议这样做:
- 除了单次请求超时和轮询预算,再给“过验证码并完成提交”这一整段设置一个外层上限。
- 超时触发时,取消还在进行的查询,清理定时器,按需关闭或重置页面。
- 等待期间如果页面已经跳转或上下文被销毁,直接中止当前任务,不要继续往一个失效的页面注入结果。
并发高时,考虑用回调代替轮询
大量任务同时轮询时,会有很多连接和协程长时间挂着等结果,容易耗尽连接池,也更容易触发限流。如果你用的识别服务支持 Webhook 回调,可以改成由服务端在任务完成后主动通知你,客户端不再反复查询。代价是需要一个公网可达、能处理重复通知和乱序通知的接收端。两种方式的部署条件和取舍,可以看 验证码API轮询和回调有什么区别。
一段可对照的处理流程(伪代码)
下面是通用的伪代码,用来说明各层超时如何嵌套。字段名和状态值以你所用平台的官方文档为准,不能直接运行。
总超时 = 按类型设定(例如图形任务较短,token任务 90 秒)

任务ID = 创建任务(参数),单次请求超时 + 最多重试 1~2 次并记录
若创建失败:记录原因,结束

等待 1~3 秒
循环,直到超过总超时:
    结果 = 查询结果(任务ID),网络错误只重试查询,不重建任务
    若 结果 = 完成:立即注入并提交,记录“取到结果→提交”的耗时,结束
    若 结果 = 不可解类错误:中止,检查参数
    若 结果 = 排队/限流类错误:指数退避后继续
    否则:等待 3~5 秒

超过总超时:标记超时,检查页面是否仍有效,再决定是否重新加载并新建任务
日志里记什么,排查才快
每个任务至少记录以下字段:
- 本地请求ID和平台返回的任务ID
- 验证码类型
- 创建时间、首次查询时间、完成时间
- 每次查询得到的状态和错误码
- 从取到结果到提交的间隔
- 目标站点最终是否接受
有了这些数据,就能分别统计创建阶段超时、求解耗时的P50和P95、Token过期率。下一步该调网络、调预算还是调提交顺序,就有了依据。
在 NexCaptcha 上落地时要确认的点
按 NexCaptcha 官网首页的介绍,它采用 createTask、getTaskResult、getBalance 的任务模式,支持轮询和 Webhook 两种取结果方式,密钥放在请求体的 clientKey 中,计费按千次成功识别计算,失败退款。上面的分层超时、幂等重试和回调方案可以直接对应到这套流程。
首页没有说明的内容需要在接入前确认:任务超时时具体返回哪个错误码,以及超时或失败任务的退款何时回到余额。这两点会直接影响重试规则和对账,建议在小流量联调时实际观察,或者通过官网首页的工程师联系入口确认。语言层面的完整接入步骤,可以参考 Python 验证码识别 API 接入 和 Node.js 验证码识别接口怎么接。


