
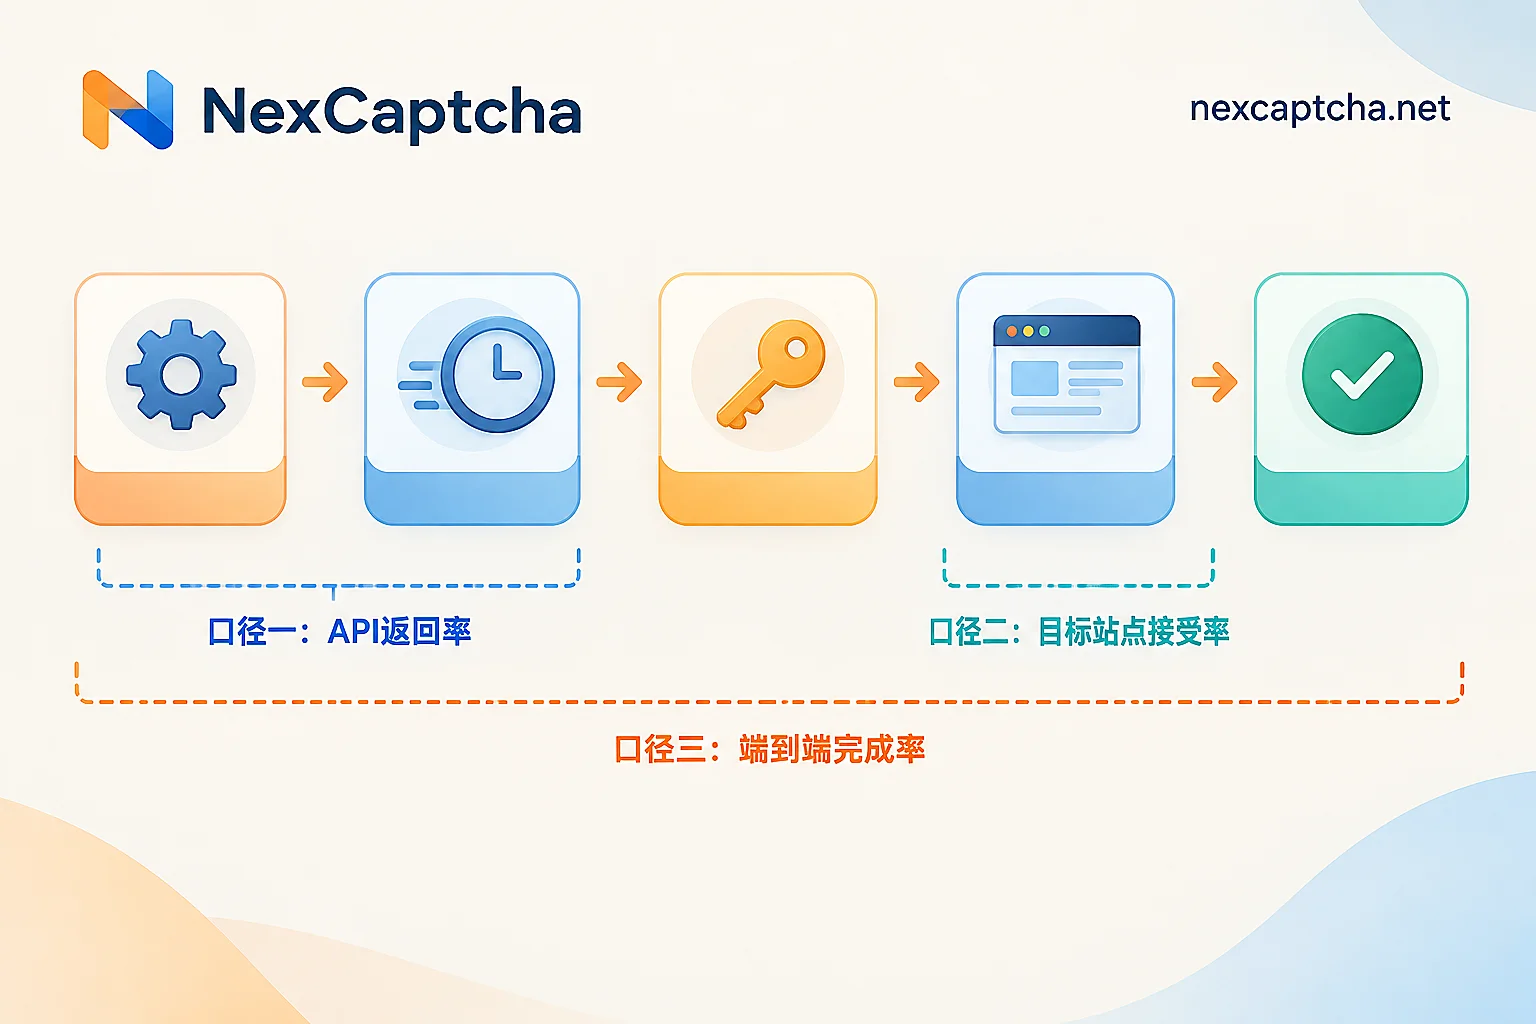
很多团队做选型时,直接拿对比表里的“成功率 95%”“98%”下判断,上线后却发现自动化任务仍有大量失败。问题通常不在百分比本身,而在它的分子分母到底是什么。验证码 API 的成功率至少要分三层来算,混用任何一层都会得出错误结论。
第一层:API 返回率——结果到底交没交回来
公式:(返回有效结果的任务数 ÷ 提交任务总数) × 100%
这一层只回答“识别服务有没有把结果给出来”。分子是状态进入完成、结果字段可用的任务;分母是所有成功提交并拿到任务 ID 的请求。失败通常表现为排队超时、任务被丢弃,或返回“无法识别”一类错误码。
计费扣费点也基本落在这层:多数平台按“成功返回结果”计费,失败不计费或部分退回,但具体规则各家的说明不同,不能默认一致。
要小心的是分母定义。如果把参数写错、密钥无效、任务类型填成大写不一致导致 400 的请求也算进分母,成功率会被自己拉低;反过来把它们剔除却不在报告里说明,数字又会虚高。建议把“请求根本没被受理”和“受理了但识别失败”分成两列记录。
第二层:目标站点接受率——结果能不能真的用
公式:(目标站点校验通过的任务数 ÷ 已提交注入目标站点的任务数) × 100%
这是最容易被忽略、也最容易误导选型的一层。API 返回 token,只说明识别服务认为这个任务结束了,并不代表目标网站认可。常见被拒原因包括:token 已过期、token 与当前会话或浏览器指纹对不上、评分型验证码分值低于业务阈值、目标站把提交所用 IP 判为可疑。
NexCaptcha 用的是任务模式:提交任务后用 getTaskResult 取结果,轮询或 webhook 接收都可以。不管换成哪家服务,只要把“拿到 token”和“业务放行”记成同一件事,第二层的失败就会被藏在第一层的高成功率里面。
第三层:端到端业务完成率——整条流程走通了没有
公式:(成功完成的业务流程数 ÷ 发起流程总数) × 100%
业务流程可以是一次检索完成、一条有效记录入库、一次提交走通。这里的失败很多跟验证码无关:账号态失效、代理 IP 被限、目标站 5xx、页面结构改了。排障时要把验证码层的返回和业务层的状态解耦来看,否则会把其他环节的问题全算到识别服务头上,然后换一家供应商再犯一次同样的错。
不同验证码类型,“成功”的判定标准不一样
三层框架通用,但每一层的判定随类型变化:
- 普通图形/字符验证码:看字符是否完全匹配,多一位少一位都算失败,报错退回规则也要计入成本。
- Token 型(reCAPTCHA v2、Turnstile、hCaptcha 等):交付物是 token,必须在有效期内提交并完成后端校验。token 有生存时间,普遍是分钟量级,拿到后放太久再用,基本等于白识别。
- 评分型(reCAPTCHA v3 / Enterprise):拿到 token 不等于通过。服务端会给出风险评分,目标站自己决定阈值和后续动作——直接放行、二次验证还是拒绝。所以这类任务的成功率只能由目标站的实际行为来定义,不能写成“识别服务返回了什么”。
- 整页防护与 WAF(Cloudflare Challenge、DataDome、AWS WAF 等):校验往往绑定 TLS 指纹、IP、UA、Cookie 等一整套环境。独立生成的凭据如果和客户端环境不一致会直接判无效。这类场景里,代理质量和浏览器环境对结果的影响,可能比识别本身更大。
成功率要带窗口和样本,延迟要分位数
“上周 98%”和“昨天 92%”可能只是样本不同,或者目标站策略变了。任何只给一个百分比、不给统计窗口、样本量、任务类型分布的数字,都只能当参考。
延迟和成功率是两个维度,都要标口径。平均值会把长尾抹平;P50 反映中位数体验,P95 反映最慢那 5% 的体验。对自动化任务来说,P95 往往比平均值更能预测超时和重试成本。厂商自述的分位数指标也应当写清统计窗口和样本口径,站方口径不等于你环境里的实测结果。
把单价换成有效千次完成成本
单价低不等于便宜。真正可比的是有效成本:
有效成本 = 总支出 ÷ (目标站点接受数 ÷ 1000)
举一个算例(均为假设数字,不是实测):A 服务千次报价 0.8,接受率 60%;B 服务千次报价 1.2,接受率 90%。要拿到 1000 次被接受的完成,A 需提交约 1667 次,支出约 1.33;B 需提交约 1111 次,支出约 1.33。价格差在有效口径下被抹平,而 A 多出来的 40% 提交还会拉长 P95、挤占代理带宽和并发预算。
这里还有一个变量是失败退费的范围:有的平台失败即退,有的只对特定错误码退。比较之前先把计费口径、计费单位、币种和统计周期对齐,否则公式再对也算不准。NexCaptcha 公开说明是按千次成功识别计费,并提供失败退款和阶梯量级优惠;具体到你的任务类型和用量档位,仍应以当时官方页面上的说明为准,不要用最低档单价去估算所有类型。
做一次能支撑决策的对照测试
想得到可信数据,关键是只让被比较的那一个变量变:
- 固定环境:同一批代理 IP、同样的 UA 与浏览器指纹、同一目标环境。
- 固定并发:各服务在相同并发下分流,避免排队差异影响结果。
- 固定窗口:同一时间段采样,记录样本量和任务类型分布。
- 记满三列:API 返回状态、目标站是否接受、业务是否完成。缺一列就分不清失败在哪一层。
- 分开展示 P50/P95,不要只报一个平均值。
- 先小流量验证,再决定是否放量;这是把迁移和切换风险压到最低的做法。
落地埋点:最小字段集
要让成功率变成可持续监控的指标,最少要记这些字段:任务类型、提交时间、返回时间、返回状态与错误码、结果是否注入成功、目标站响应、业务最终状态。有了这几类字段,三层成功率可以自动算出来,下次故障也不用靠猜。
相关阅读:失败集中在提交之后,可以看验证码 token 返回后验证失败怎么排查;任务大量停在处理中,先看验证码任务一直 processing 怎么办;轮询和回调该选哪个见验证码API轮询和回调有什么区别;成本口径的细节见打码平台费用对比。NexCaptcha 支持的验证码类型、计费说明和工程师联系入口都在官网首页(https://nexcaptcha.net/),需要看产品能力时可以从那里开始核对。


