
hCaptcha 识别 API 不会替你“点掉”页面上的验证码。它根据页面参数,在服务端异步生成一个 hCaptcha 响应 Token,再由你的自动化流程把它交给页面。接入时最容易出问题的有四处:参数采集不全、Token 过期、注入后没有触发页面回调,以及会话环境前后不一致。
下面按实际接入顺序说明。适用场景是自有系统或获得授权的测试、监控与自动化工作流。
先弄清 Token 是怎么被验证的
用户在页面上通过 hCaptcha 后,页面里会多出一个响应 Token,通常以 P1_ 开头,存放在隐藏的 textarea[name="h-captcha-response"] 中。部分站点出于兼容考虑,也会读取 g-recaptcha-response。
表单提交后,目标站后端会把这个 Token 和自己的 secret、sitekey 一起,以 URL-encoded POST 发给 https://api.hcaptcha.com/siteverify 校验,有时还会附带客户端的 remoteip。
这个机制带来三个直接约束:
- Token 只能用一次。同一个 Token 不能重复提交,重试时要重新创建任务。
- Token 有有效期,通常约 120 秒。从创建任务到提交表单,整个过程都要在这个窗口内完成。
- 校验发生在目标站后端。识别服务返回了 Token,只说明第一步完成了。目标站是否接受,取决于它的 siteverify 结果和自身的风控规则。
提交任务前要采集哪些参数
第三方识别 API 的 hCaptcha 任务一般需要以下信息。具体字段名以所用平台的当前文档为准。
- websiteURL:出现验证码的页面完整地址,不要只填域名。
- websiteKey(sitekey):页面上的 hCaptcha 公钥,常见于
data-sitekey属性或hcaptcha.render()的参数中。 - rqdata(仅 Enterprise 场景):hCaptcha 分标准版(Checkbox / Invisible)和 Enterprise 版。Enterprise 页面常会动态生成一段上下文数据,有的平台称为
rqdata,也有的称为enterprisePayload。只要页面提供了这段数据,就要在每次创建任务时抓取当前这一次的值并一起提交。数据缺失或使用了旧值,生成的 Token 很可能通不过目标站的校验。 - 代理模式选择:多数平台同时提供 Proxyless(使用服务方出口)和 Proxy(使用你自备的代理)两种任务。如果目标站校验
remoteip,或者对指纹、TLS 审查比较严格,应选 Proxy 模式,让解题出口和你的浏览器出口保持一致。只有在不涉及这些检查时,Proxyless 才是更省事的选择。
任务流程:创建、等待、取回
主流验证码 REST API 都采用异步任务流程:
- 调用 createTask 提交任务,拿到
taskId; - 通过 getTaskResult 轮询任务状态,或者事先配置 webhook,等待完成通知;
- 状态变为完成后,取出 Token。
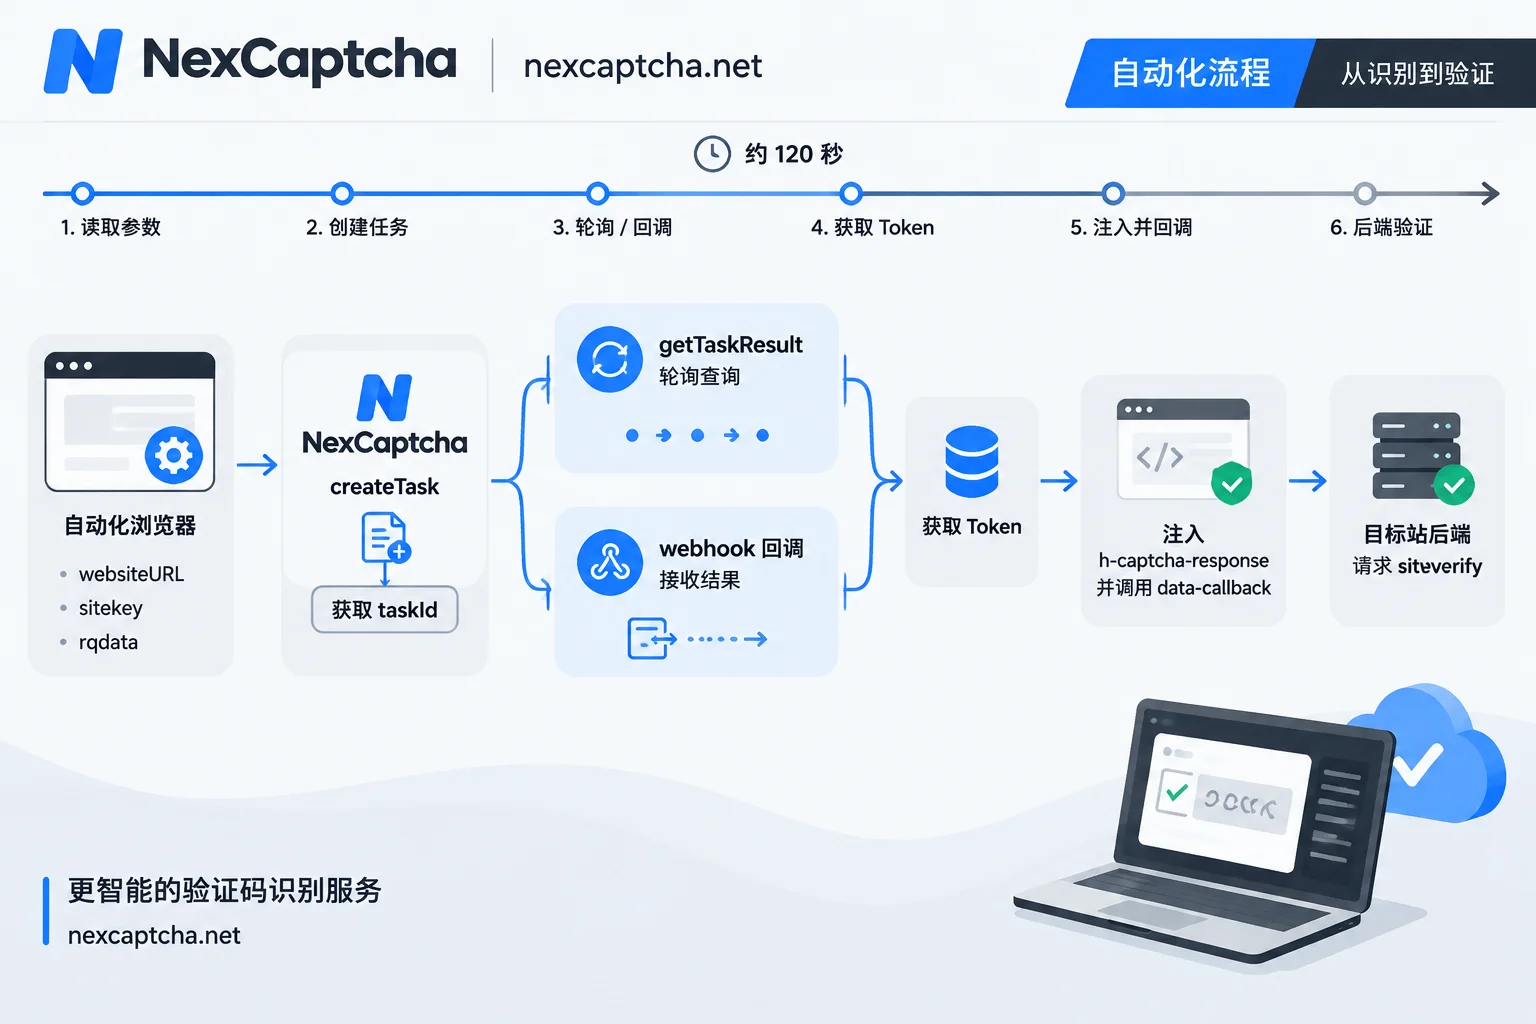
由于 Token 有效期大约只有 120 秒,等待策略要按这个窗口来规划:
- 轮询间隔不要太长,也不要过于密集;
- 为单次任务设置总超时,超时后放弃这次任务并重新创建,不要拿着可能已过期的 Token 继续提交;
- 如果流程中有排队、重试或人工步骤,把这些耗时也算进时间预算。
轮询和回调各适合什么部署条件,可以参考 验证码 API 轮询和回调的区别。Python 中的提交、轮询和异常处理写法,可以参考 Python 验证码识别 API 接入。
以 NexCaptcha 为例,官网介绍的接口是统一 REST 任务模式,提供 createTask、getTaskResult、getBalance 三个方法,API 域名为 api.nexcaptcha.net,密钥放在请求体的 clientKey 字段中。下面的示例只是伪代码,用来说明数据结构。hCaptcha 的任务类型名、Enterprise 字段名和端点路径,都请以当前 API 文档为准:
// 伪代码:字段名与类型名以当前官方文档为准,不可直接运行
createTask 请求体:
{
  "clientKey": "<YOUR_CLIENT_KEY>",
  "task": {
    "type": "<hCaptcha 任务类型,按文档区分 Proxyless / Proxy>",
    "websiteURL": "https://your-test-site.example/login",
    "websiteKey": "<页面 sitekey>",
    "<Enterprise 上下文字段>": "<当前页面的 rqdata,仅在存在时提交>"
  }
}

→ 返回 taskId
→ 用 getTaskResult 轮询,或等待 webhook 通知
→ 状态完成后读取 Token
密钥只应保存在环境变量或密钥管理服务中,不要写进代码仓库或日志。
在 Playwright / Puppeteer / Selenium 中使用 Token
拿到 Token 后,只把它填进 textarea,表单往往还是不会继续。原因是很多 hCaptcha 集成配置了 data-callback:页面要等这个回调函数被调用,才会启用提交按钮或进入下一步。
通用做法分两步:
- 把 Token 写入
h-captcha-response。如果页面也读取g-recaptcha-response,一并写入。 - 找到回调函数并调用它。函数名可以在 hCaptcha 容器的
data-callback属性里找到。如果站点是通过hcaptcha.render()以 JS 方式渲染的,回调则写在渲染参数中,需要阅读页面脚本才能确认。
Playwright 中的示意写法如下。Puppeteer 的 page.evaluate() 写法基本相同,Selenium 可以用 execute_script 实现:
// 示意代码:仅用于自有或获授权的测试页面
await page.evaluate((token) => {
  document.querySelectorAll('textarea[name="h-captcha-response"], textarea[name="g-recaptcha-response"]')
    .forEach((el) => { el.value = token; });
  const box = document.querySelector('[data-callback]');
  const fnName = box && box.getAttribute('data-callback');
  if (fnName && typeof window[fnName] === 'function') {
    window[fnName](token);
  }
}, token);注入和提交要发生在同一个浏览器会话里。并发运行多个任务时,要用 taskId 和页面实例做好对应,避免把 A 页面的 Token 交给 B 页面。
识别服务返回了 Token,目标站却不接受:排查顺序
先确认问题出在哪个阶段:
- 结果返回:识别服务已经交回 Token;
- 目标站接受:siteverify 校验通过;
- 业务完成:登录成功、拿到数据,或者表单真正提交成功。
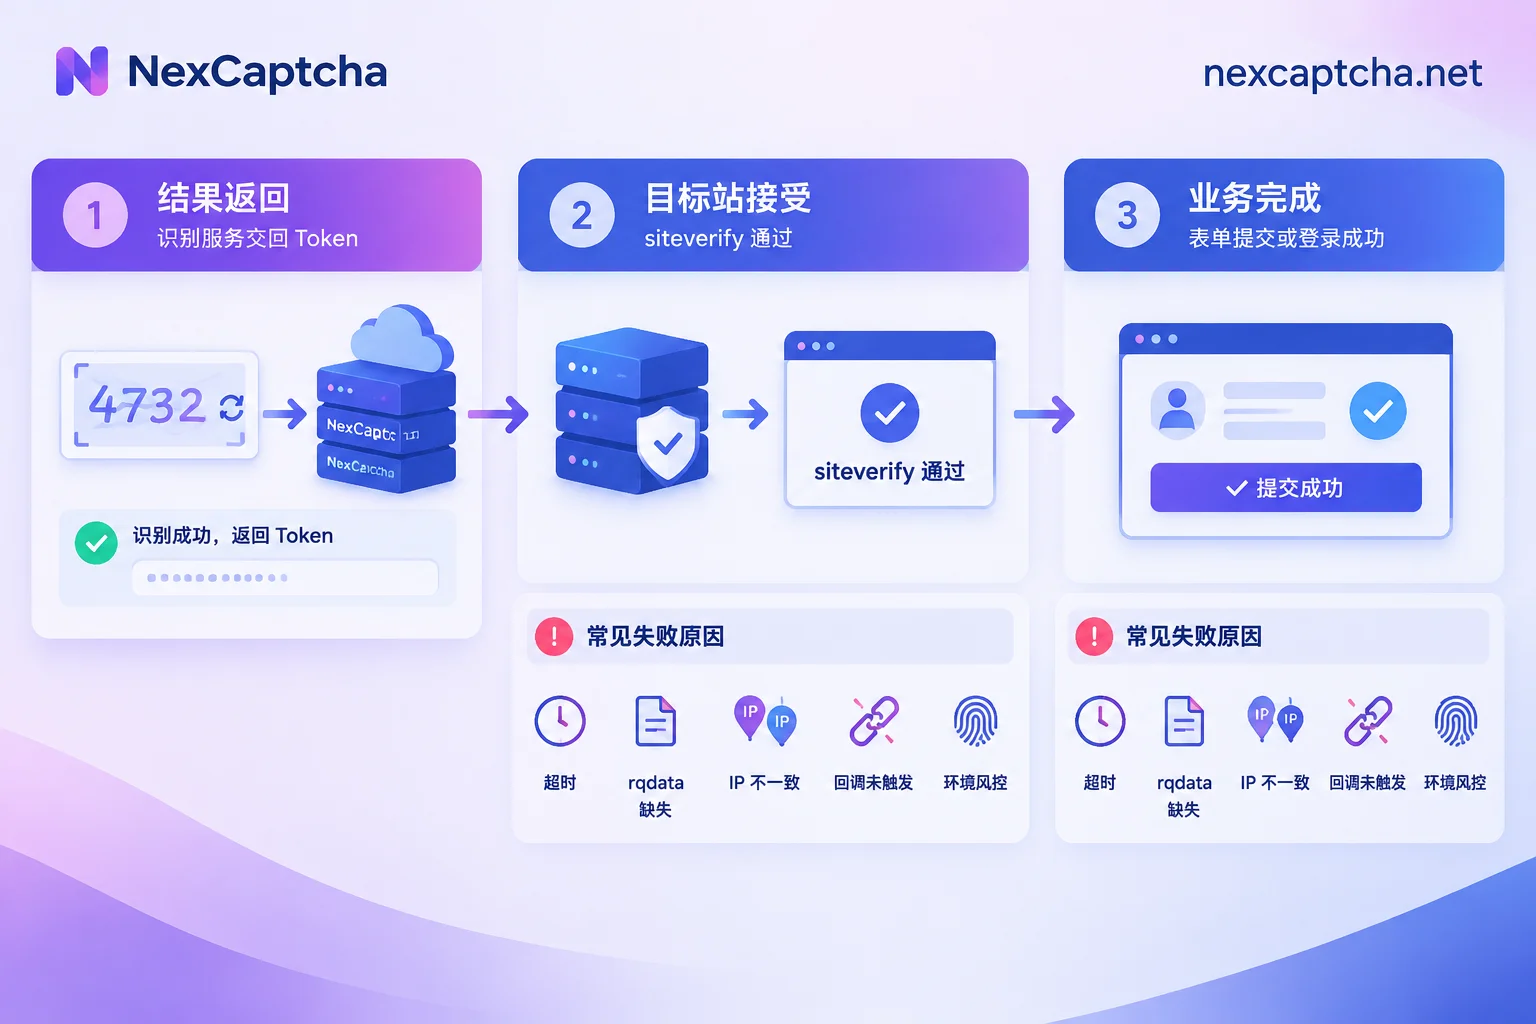
如果 Token 已经拿到,但后两个阶段失败,可以按下面的顺序检查:
- 是否超时:记录从 createTask 到表单提交的耗时。如果接近或超过约 120 秒,先压缩等待和中间步骤的时间。
- 是否是 Enterprise 页面:确认页面是否有 rqdata 之类的上下文数据,以及每次任务提交的是否是新抓取的值。
- IP 是否一致:如果目标站在 siteverify 时附带了
remoteip,而你使用的是 Proxyless 任务,就可能因 IP 不一致被拒。可以改用 Proxy 模式,并让它和浏览器使用同一出口。 - 回调是否触发:Token 写进去了,但页面没有进入下一步,通常是
data-callback没有被调用,或者调用了错误的函数。 - 综合风控:WebDriver 标记、浏览器指纹、TLS 特征等问题,也可能导致请求被拒,验证码失败只是表面现象。这类问题要从浏览器环境本身排查,更换识别服务通常无法解决。
不要一看到失败就归结为“IP 不行”或“识别服务不行”。按上面的阶段分别记录日志,才能定位真正卡住的环节。
QA 场景:能用测试密钥就先用测试密钥
如果你测试的是自家系统,hCaptcha 官方为开发环境提供了测试用的 sitekey 和 secret。CI 回归测试一般用测试密钥就能覆盖表单流程,不需要额外的付费识别步骤。只有在需要和真实验证码联调,或者验证生产配置时,才有必要接入识别 API。环境隔离的做法可以参考 Playwright 验证码测试怎么做。
选型与上线前的小流量验证
NexCaptcha 官网列出的支持类型中包含 hCaptcha,计费方式自述为按千次成功识别收费,识别失败退款,并提供测试额度。不过目录中列出支持,不等于在任何站点、任何会话下都能通过。尤其是 Enterprise 字段的命名、Proxy 任务的写法,以及 hCaptcha 题型对应的耗时分布,都应以当前文档和你自己的测试结果为准。
建议先用一个获授权的目标页面做小流量测试,至少记录这几项:
- Token 返回率;
- 目标站接受率,并写明分母是什么;
- P50 和 P95 耗时,二者分开统计,不要与平均值混用;
- 每条有效结果的实际成本。
扣费和退款的计算方法见 验证码 API 按千次怎么计费。如果是从其他平台迁移过来,要逐项核对任务类型名、字段和回调格式,可参考 2Captcha 替代方案怎么选。
确认需求后,可以在 NexCaptcha 官网 查看当前支持的验证码类型、价格和迁移说明,也可以通过首页联系工程师,确认 hCaptcha Enterprise 的具体参数要求。


