
Playwright 测试被验证码卡住时,先不要去找“绕过”技巧。如果测的是自己的系统,做 E2E 和 CI 回归最稳的办法,是让验证码在测试环境里产生可预期的结果:使用验证码厂商提供的官方测试密钥,或者在测试环境关闭、放行校验。只有预发冒烟、获授权的全链路联调这类必须面对真实验证码的场景,才需要接入外部识别服务。这种情况下,断言要把“拿到 token”和“业务真正完成”分开写。
先判断你属于哪种场景
- 本地开发、PR 检查、夜间回归(自有系统):要验证的是表单、登录、下单这些业务逻辑,验证码本身不是被测对象。用测试密钥或环境开关即可。
- 验证验证码集成本身:比如前端组件能否渲染、后端是否正确调用校验接口、失败时是否给出提示。用测试密钥里“总是通过”和“总是失败”两种组合来覆盖。
- 预发或生产冒烟、获授权的第三方系统联调:页面用的是真实 sitekey 和真实风控,你改不了配置。这时需要外部识别服务配合 Playwright 注入 token。
不在授权范围内的目标站点,不属于测试讨论的范围。
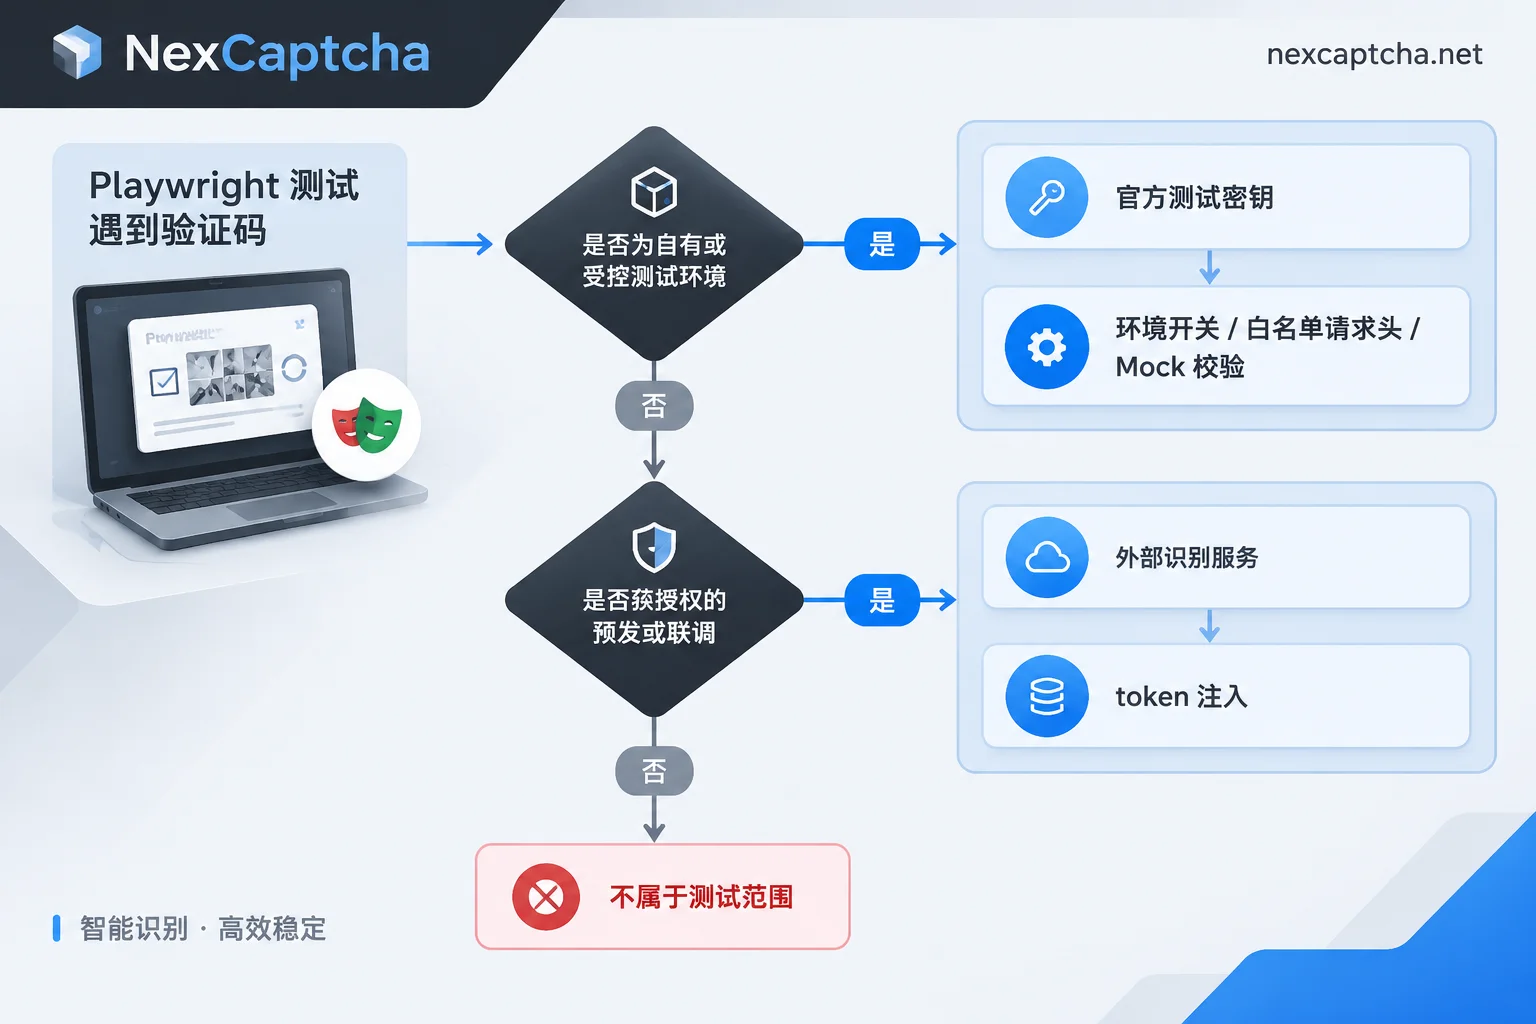
方案一:用官方测试密钥让结果可预期
reCAPTCHA v2:Google 在 reCAPTCHA FAQ 中提供了一个固定的测试 sitekey 6LeIxAcTAAAAAJcZVRqyHh71UMIEGNQ_MXjiZKhI,以及配套的 secret key。使用这组密钥时,校验请求始终通过,组件上会显示测试用途的提示。reCAPTCHA Enterprise 的密钥体系和 v2 不同,测试方式请以 Google Cloud 的密钥说明为准,不要直接套用 v2 的测试密钥。两个版本在交互和校验上的差别,可以参考reCAPTCHA v2 和 v3 区别。
Cloudflare Turnstile:官方提供公开的测试 sitekey。例如 1x00000000000000000000AA 始终通过,2x00000000000000000000AB 始终失败,另外还有对应的测试 secret key。把这两个 sitekey 分别用在两组测试里,就能同时覆盖“验证通过后正常提交”和“验证失败时正确拦截并提示”。
落地时,让应用从环境变量读取 sitekey 和 secret,由测试环境注入测试值。Playwright 的 webServer 可以直接给被测服务传环境变量:
// playwright.config.ts(片段)
import { defineConfig } from '@playwright/test';

export default defineConfig({
  webServer: {
    command: 'npm run start',
    url: 'http://localhost:3000',
    env: {
      TURNSTILE_SITE_KEY: '1x00000000000000000000AA',
      TURNSTILE_SECRET_KEY: '<Cloudflare 文档中的测试 secret>',
    },
  },
});
反向用例需要另起一个使用 2x...AB 的服务实例,或者单独建一个 CI job。
有几点要注意:
- 测试密钥只能出现在测试配置里。可以在发布流水线中加一步检查,确认生产配置不含测试值。
- 测试密钥只能证明集成代码的流转是对的,不能证明生产密钥、域名绑定、风控阈值也配置正确。上线前仍需在真实环境做少量验证。
- Turnstile 测试密钥只作用于页面里嵌入的 Turnstile 组件。Cloudflare 整页 Challenge 由站点防护规则触发,和页面 sitekey 无关,需要在自己的 Cloudflare 规则中单独处理测试流量。两者的区别见Turnstile 和 5 秒盾有什么区别。
方案二:环境开关、白名单请求头或 Mock 校验
如果测试密钥不方便使用(例如一套测试环境要同时服务手工测试),可以在测试环境里直接放行:
- Feature Flag 关闭验证码:最简单。代价是前端组件和后端校验都不在测试覆盖范围内。
- 白名单请求头:后端识别到特定请求头就跳过校验。在 Playwright 中可以用
use.extraHTTPHeaders统一加头,但它会随页面发出的所有请求一起发送,包括第三方域名。如果只想发给自家接口,可以用路由按域名追加:
test.beforeEach(async ({ context }) => {
  await context.route(`${process.env.BASE_URL}/api/**`, async (route) => {
    await route.continue({
      headers: { ...route.request().headers(), 'x-e2e-bypass': process.env.E2E_BYPASS_TOKEN ?? '' },
    });
  });
});
这个请求头的值要当作密钥来管理:存放在 CI Secret 中,只在测试环境生效,并定期轮换。
- Mock 后端校验:向验证码厂商核验 token 的请求是后端发出的,Playwright 的
page.route拦截不到。要做 Mock,就在后端通过依赖注入或测试替身,把校验结果固定下来。
这些做法的共同好处是:测试结果不再受风控波动影响,可以避免大量偶发失败(flaky tests)。
为什么不建议靠 stealth 插件和模拟鼠标轨迹
模拟人类鼠标轨迹、加随机延迟、加载 stealth 插件,这些办法在本地偶尔能过。但 Turnstile、reCAPTCHA v3、DataDome 这类防护会综合判断浏览器指纹、TLS 特征、运行环境和网络信誉,单靠行为模拟很难长期稳定。CI 机器多为数据中心出口,无头环境特征也更明显,今天能通过的配置明天可能失效,不适合作为回归测试的基础。
方案三:必须面对真实验证码时的联调流程
在获授权的预发冒烟或全链路验收中,常见流程分四步:
- 提取参数:定位验证码容器,读取 sitekey 和当前页面 URL。reCAPTCHA v3 和 Enterprise 通常还需要 action。有些页面的参数由 JS 动态渲染,要等组件加载完成后再读取。
- 创建识别任务并取结果:调用识别服务的 REST 接口,先创建任务,再通过轮询或回调拿到 token。
- 注入并触发提交:用
page.evaluate()把 token 写入隐藏字段,例如g-recaptcha-response或cf-turnstile-response。如果组件配置了data-callback,页面的提交逻辑往往依赖这个回调,还需要用 token 调用对应的回调函数。 - 断言业务结果:检查登录后跳转、订单号、成功提示这类业务结果。
import { test, expect } from '@playwright/test';

test('预发登录冒烟 @captcha-real', async ({ page }) => {
  await page.goto(process.env.STAGING_LOGIN_URL!);

  // 1. 提取参数(以 reCAPTCHA v2 为例)
  const siteKey = await page.locator('[data-sitekey]').first().getAttribute('data-sitekey');
  const pageUrl = page.url();

  // 2. 调用识别服务(下方为伪代码,任务类型与字段名以服务商当前文档为准)
  const token = await solveCaptchaTask({ type: '<任务类型>', websiteURL: pageUrl, websiteKey: siteKey });

  // 3. 注入 token
  await page.evaluate((t) => {
    const field = document.querySelector<HTMLTextAreaElement>('textarea[name="g-recaptcha-response"]');
    if (field) field.value = t;
  }, token);

  // 4. 提交并断言业务结果,而不是只断言拿到了 token
  await page.getByRole('button', { name: '登录' }).click();
  await expect(page).toHaveURL(/dashboard/);
});
其中 solveCaptchaTask 需要你按所用服务的文档自行实现,逻辑大致如下(伪代码,不可直接运行):
solveCaptchaTask(params):
  taskId = POST createTask { clientKey, task: params }
  在总超时之内循环:
    等待几秒
    r = POST getTaskResult { clientKey, taskId }
    如果 r 已完成: 返回 r 中的 token
    如果 r 返回错误: 记录错误码并抛出,不要无条件重试
  抛出超时错误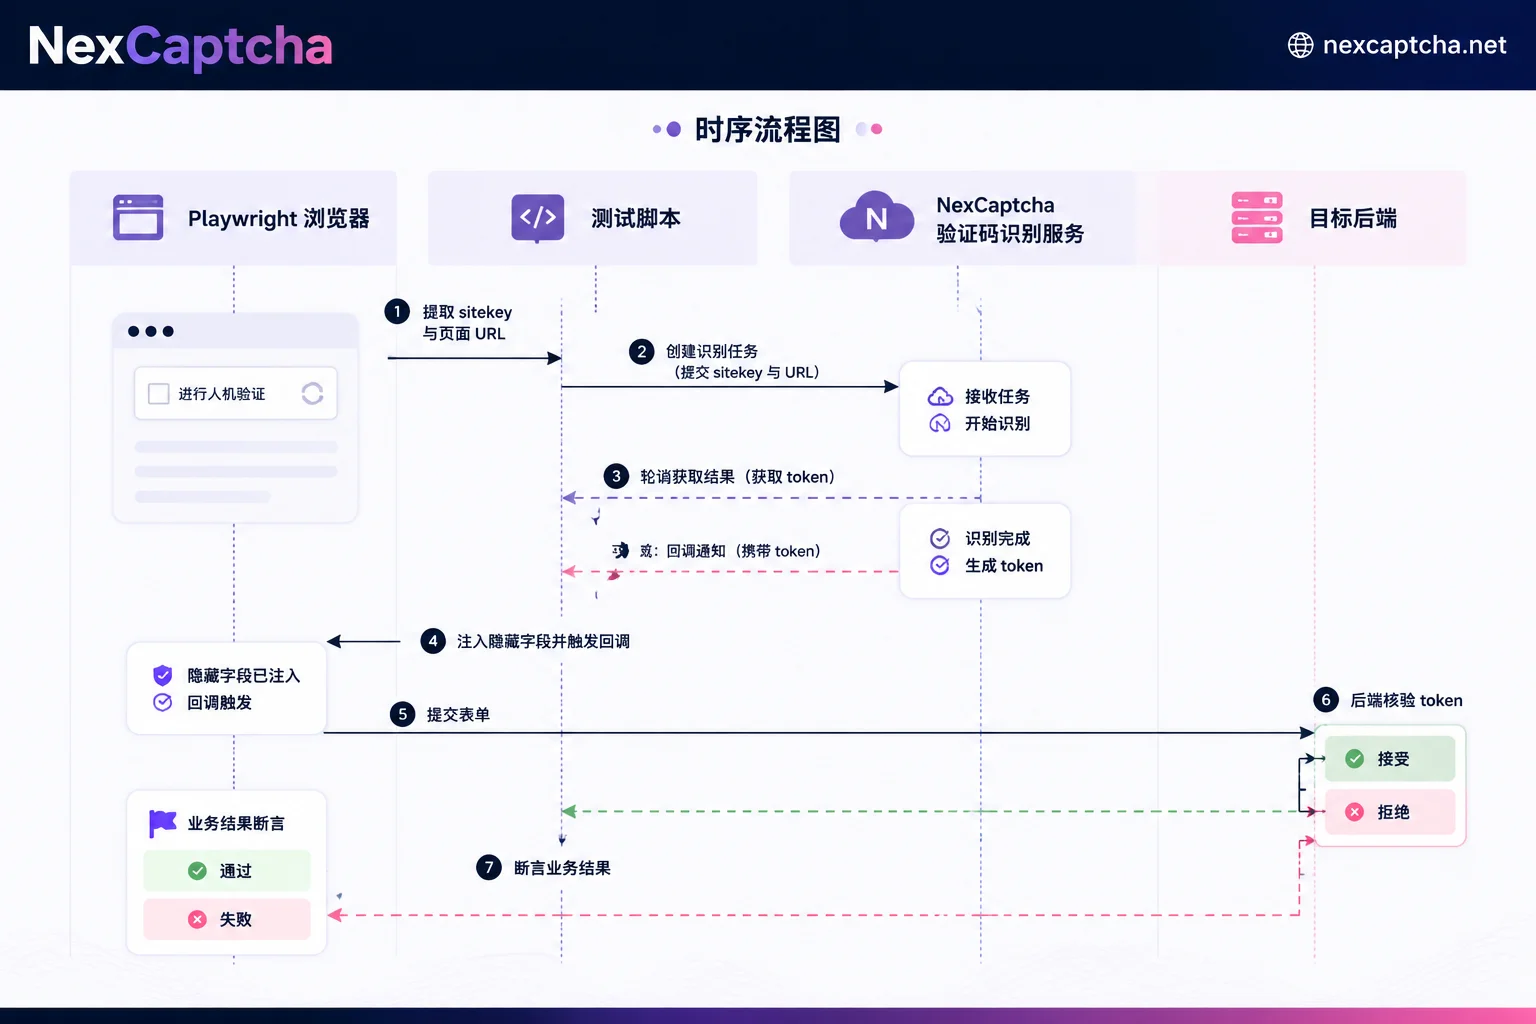
token 有有效期,拿到后应尽快注入并提交。不要先取 token 再去执行一长串其他步骤。整个用例的超时时间,要把识别耗时也算进去。
断言要分三层
真实验证码的用例失败时,先弄清失败发生在哪一层:
- 识别服务是否返回了 token:如果失败,原因可能是参数提取错误、任务类型选错,或者服务端超时。
- 目标后端是否接受了 token:这是最容易被忽略的一层。reCAPTCHA v3 和 Enterprise 这类评分型验证码,对执行环境的 IP 和上下文比较敏感。如果浏览器的出口网络和识别时使用的网络参数对不上,就可能出现 token 已经返回、后端核验却因低分拒绝的情况。
- 业务是否完成:后端接受了 token,也不代表流程一定走完,还可能卡在其他校验上。
在测试报告里给失败打上层级标签,排障时就不会把所有问题都归到“验证码服务不行”或“IP 被封”上。
在 CI 中如何组织
- 分组运行:给真实验证码用例打上
@captcha-real之类的标签,只在预发的定时任务里跑。PR 检查只跑使用测试密钥的用例。 - 密钥管理:识别服务的密钥放在 CI Secret 里,不写进代码或日志。Playwright 的 trace 和截图可能记录注入后的表单内容,公开或共享 CI 产物前要确认。
- 控制重试和成本:即使服务按成功次数计费,重试也会消耗时间和配额。建议给真实验证码用例单独设置重试上限。计费口径的计算方法见验证码API按千次怎么计费。
NexCaptcha 能承担哪一步
上面第 2 步的识别环节,可以交给 NexCaptcha 这类识别服务。按官网说明,NexCaptcha 采用统一的 REST 任务模式:createTask 创建任务,getTaskResult 查询结果,也支持 webhook 回调,getBalance 查询余额。接口域名为 api.nexcaptcha.net,密钥通过请求体中的 clientKey 传入。官网列出的类型包括 reCAPTCHA v2/v3/Enterprise 和 Cloudflare Turnstile/Challenge 等。具体任务类型名称和字段,请以当前官方说明为准。
它只负责返回识别结果。浏览器会话、参数提取、token 注入和业务断言,仍由你的 Playwright 代码完成。能用测试密钥解决的自有系统回归,不需要为此增加付费步骤。确实有预发冒烟或授权联调需求时,建议先用少量用例验证目标系统的接受情况,再决定是否纳入定时任务。验证码类型、计费方式和工程师联系方式可以在 NexCaptcha 官网查看;如果你用 Python 编写辅助脚本,可以参考Python 验证码识别 API 接入中的轮询与异常处理写法。


