
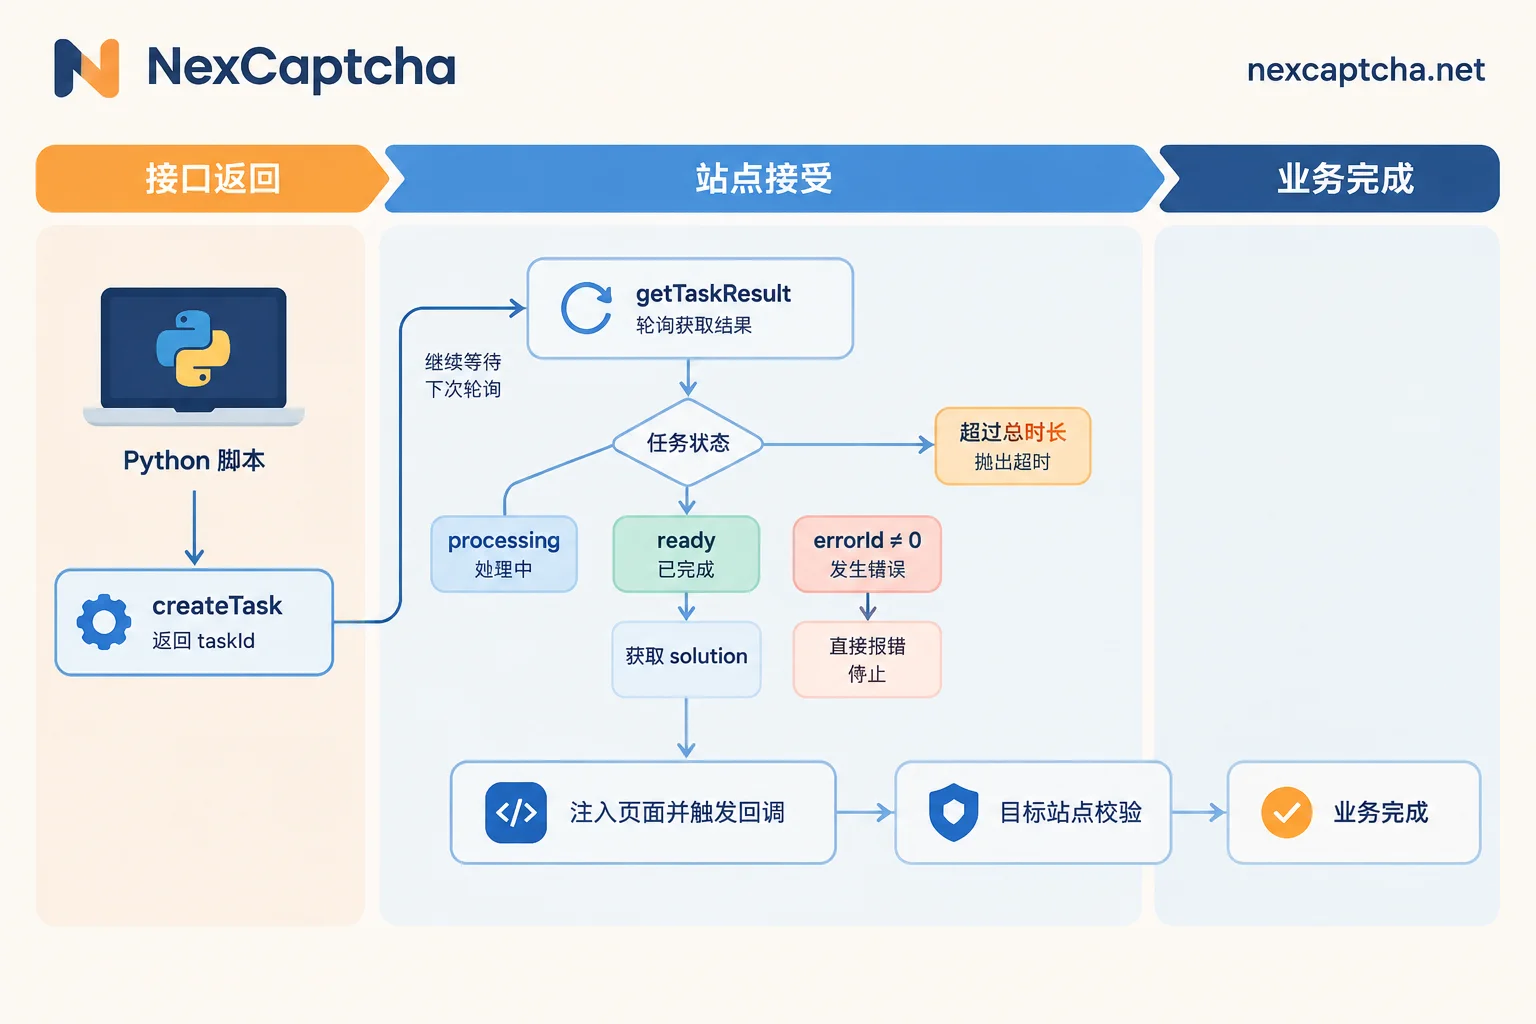
用 Python 接入验证码识别 API,常见做法是“两段式”调用。先调用 createTask 提交任务,拿到 taskId;再每隔几秒调用 getTaskResult,直到状态变成 ready 并取出 solution,或者超过设定的总时长后放弃。整个过程用 requests 就能完成,不依赖特定 SDK。
真正容易出问题的地方有三个:
- 任务类型选错,参数也就填错了;
- 轮询没有上限,出错后还在继续请求;
- 拿到 Token 后没有正确注入页面,或者站点拒绝了它,却误以为是识别服务坏了。
下面按实际接入顺序说明。
本文讨论的场景是自有或获授权系统的测试、无障碍辅助,以及允许的公开数据工作流。
第一步:先确认你要的是文字还是 Token
验证码识别任务大致分两类,输入和产出完全不同。
图形验证码(OCR 类)
- 你提交的是验证码图片,通常先转成 Base64。
- 返回的是图片里的明文字符,比如
x7Kp2。 - 拿到后直接填进输入框即可。
交互式或行为式验证码
- 包括 reCAPTCHA v2/v3/Enterprise、Cloudflare Turnstile、hCaptcha 等。
- 你不提交图片,而是提交目标页面地址(常见字段名
websiteURL)和站点公钥(websiteKey或 sitekey)。 - 返回的是一串加密的验证令牌(Token),需要放回页面表单,由目标站点的后端去校验。
这个区别决定了后面的所有代码怎么写。比如 reCAPTCHA v2 和 v3 的任务类型不同,v3 通常还需要 action 等参数。Turnstile 组件和 Cloudflare 整页 Challenge 也不是同一种任务,详见Turnstile 和 5 秒盾的区别。reCAPTCHA 的工作原理可以参考这篇 reCAPTCHA 自动化链路说明。
各服务商的任务类型名称大小写不一样,字段细节也不一样,比如是否区分带代理(Proxy)和不带代理(Proxyless)的版本。这些都要以你所用服务的当前文档为准。
第二步:写一个带超时和错误检查的通用客户端
下面是通用的两阶段结构示意。字段名采用业内常见的 clientKey、taskId、errorId、status、solution 写法。上线前请逐项对照你所用服务的文档,确认端点路径和响应字段。
import os
import time
import requests

API_BASE = os.environ['CAPTCHA_API_BASE']     # 服务商 API 地址,路径以其文档为准
CLIENT_KEY = os.environ['CAPTCHA_CLIENT_KEY'] # 密钥只从环境变量读取

class CaptchaError(Exception):
    pass

def _post(path, payload, timeout=15):
    resp = requests.post(f'{API_BASE}/{path}', json=payload, timeout=timeout)
    resp.raise_for_status()
    data = resp.json()
    if data.get('errorId', 0) != 0:
        # 业务错误(密钥无效、余额不足、参数错误等):立即停止,不要继续轮询
        raise CaptchaError(f"{data.get('errorCode')}: {data.get('errorDescription')}")
    return data

def create_task(task: dict) -> str:
    data = _post('createTask', {'clientKey': CLIENT_KEY, 'task': task})
    return data['taskId']

def wait_result(task_id, first_wait=5, interval=3, deadline=120):
    end = time.monotonic() + deadline
    time.sleep(first_wait)
    while time.monotonic() < end:
        try:
            data = _post('getTaskResult', {'clientKey': CLIENT_KEY, 'taskId': task_id})
        except requests.RequestException:
            time.sleep(interval)   # 网络抖动:只重试查询,不重新建任务
            continue
        if data.get('status') == 'ready':
            return data['solution']
        time.sleep(interval)
    raise TimeoutError(f'任务 {task_id} 在 {deadline} 秒内未完成')
这段代码里有几个关键决定,下面逐一说明原因。
- 单次请求必须设置
timeout。requests默认不超时,服务端一旦卡住,你的脚本就会一直挂着。单次请求设 10–15 秒比较常见。 - 轮询要有总时长上限。Token 类任务通常需要十几秒到几十秒,总上限设 60–120 秒比较合理。轮询间隔 2–3 秒即可,间隔太短只会增加请求量,不会更快出结果。
- 先检查
errorId,再看status。非零错误说明任务本身出了问题,这时继续轮询只会浪费时间和配额,应该立即上报。 - 网络异常只重试查询,不重复创建任务。如果
createTask超时后直接重发,可能会产生两个任务。建议先记录日志,确认第一个任务的去向后再决定是否重建。 - 密钥只放环境变量或密钥管理服务。不要写进代码仓库、日志,也不要出现在截图里。
如果并发量比较大,可以考虑用回调(webhook)代替轮询,由服务端在任务完成时主动推送结果。回调的签名方式和重试规则要看具体服务的文档。
第三步:按任务类型构造 task
图形验证码的 task 大致如下:
import base64

with open('captcha.png', 'rb') as f:
    img_b64 = base64.b64encode(f.read()).decode()

task = {'type': '<图形识别任务类型>', 'body': img_b64}
text = wait_result(create_task(task)).get('text')
Token 类验证码的 task 大致如下:
task = {
    'type': '<reCAPTCHA v2 任务类型>',
    'websiteURL': 'https://your-test-site.example/login',
    'websiteKey': '<页面上的 sitekey>',
}
solution = wait_result(create_task(task))上面尖括号里的内容要换成服务文档中的真实值。solution 里 Token 的字段名因服务和任务类型而异,常见的有 gRecaptchaResponse、token 等,请以实际响应为准。
第四步:在 Selenium / Playwright 中注入 Token
拿到 Token 只完成了一半,还要把它交给页面。
一般做法是用 driver.execute_script()(Selenium)或 page.evaluate()(Playwright),把 Token 写进验证码组件对应的隐藏字段:
- reCAPTCHA:
textarea#g-recaptcha-response - Turnstile:
[name="cf-turnstile-response"]
以 Playwright 为例:
page.evaluate("""(token) => {
  const el = document.querySelector('#g-recaptcha-response');
  el.value = token;
  // 如果页面在组件上声明了 data-callback,需要手动调用它
  const cb = document.querySelector('[data-callback]')?.getAttribute('data-callback');
  if (cb && typeof window[cb] === 'function') window[cb](token);
}""", token)回调这一步经常被漏掉。很多页面并不直接读取隐藏字段,而是依赖回调函数来解锁提交按钮或发起请求。如果只填了字段,按钮不会亮,表单也就提交不上去。
另外,Token 通常只在一两分钟内有效。从拿到 Token 到提交表单,中间不要插入耗时操作。
第五步:分清三种“成功”,再排查失败
一个请求可能停在三个不同的阶段:
- 接口返回了结果:识别服务交付了文字或 Token。
- 目标站点接受了结果:站点后端校验通过。
- 业务真正完成:登录成功,或者拿到了正确的数据。
识别服务只负责第一步。目标站点在校验时,往往还会综合检查 IP、TLS 指纹、User-Agent、会话 Cookie 和 Token 时效。所以第一步成功、第二步失败,并不一定是识别服务的问题。
遇到失败时,建议按下面的顺序排查:
- 任务类型和参数:sitekey 是否取自当前页面?reCAPTCHA 的 v2、v3、Enterprise 有没有选错?v3 的 action 是否一致?
- 时效:从获得 Token 到提交用了多久?是否在等待期间做了页面刷新或跳转?
- 注入:字段是否写进了正确的 iframe 或表单?回调有没有触发?
- 会话一致性:浏览器会话、Cookie、出口 IP 在整个流程中有没有发生变化?如果服务要求提交代理参数,请求中的代理和浏览器实际用的代理是否一致?
- 服务侧错误:日志里有没有记录
errorId和errorCode?是否有大量超时?
把这三个阶段分别计数,才能算出真正有意义的成功率,并说清楚分母是什么。
在 NexCaptcha 上怎么对应
根据 NexCaptcha 官网公开的说明,它采用统一的 REST 任务接口:
- 接口包括
createTask、getTaskResult、getBalance,支持轮询和 webhook 两种方式; - API 域名为
api.nexcaptcha.net; - 密钥
clientKey放在请求体 JSON 里,而不是放在请求头。
因此,上面的通用客户端结构可以直接沿用。目前官方 Python SDK 的包名和用法还有待核验,所以用 requests 自行封装是比较稳妥的方式。具体的端点路径、任务类型名和 solution 字段,请在联调时以实际响应为准。
计费方面,官网说明按成功识别计费,失败退款,并提供测试额度。建议先用小流量,在自己的目标任务上分别测出上面三种成功口径,再决定是否扩大使用规模。选型时可以参考验证码识别 API 怎么选的六步判断。
支持的验证码类型、价格和工程师联系方式,可以在 NexCaptcha 首页查看。


