
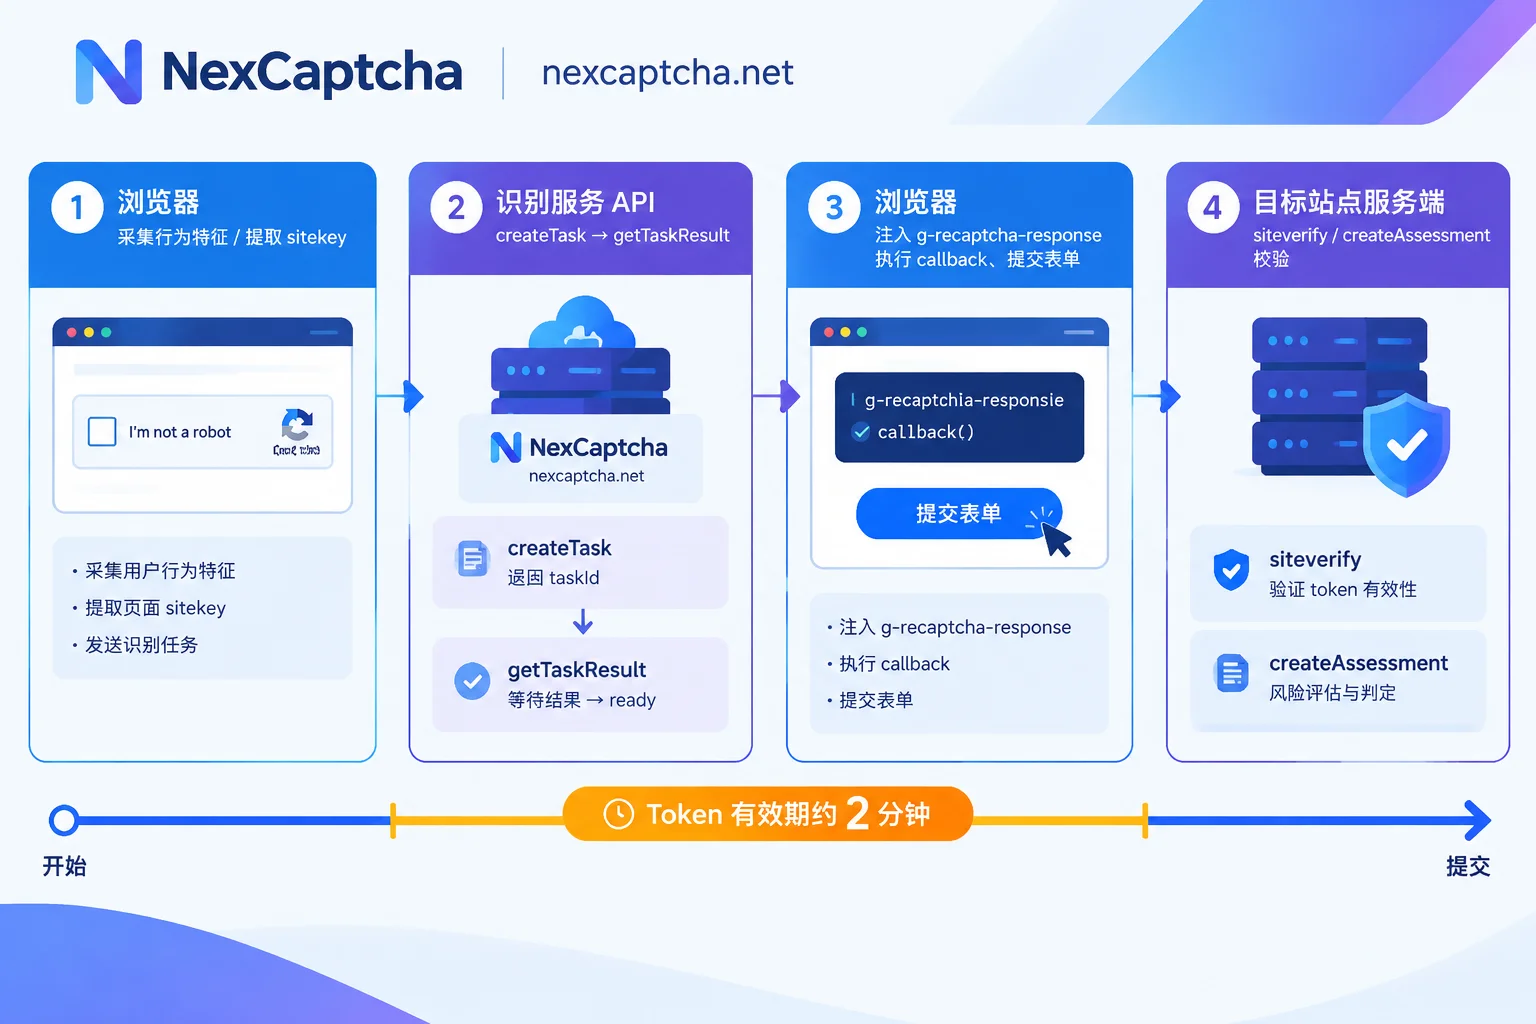
想在自动化脚本里跨过 reCAPTCHA,核心不是「让机器人去点那些红绿灯图片」,而是拿到一段 Google 签发的 Token,并让它出现在目标站点提交请求的正确位置。理解了这一点,整条链路就能拆成五个可控步骤:从页面提取参数 → 把参数交给识别服务 → 取回 Token → 注入并触发回调 → 提交并校验业务结果。
下面先讲清楚 reCAPTCHA 在做什么,再讲这条链路每一步该怎么落地、哪里最容易断。
reCAPTCHA 的三段式结构
无论 v2 还是 v3,Google 的验证流程都由三个彼此独立的角色组成:
第一段在浏览器里。 页面加载 api.js 时带上 sitekey(公钥),脚本渲染挂件或在后台采集环境特征:鼠标轨迹、点击与滚动、停留时长、浏览器与设备属性等。这一段完全跑在客户端,是自动化最容易暴露的地方。
第二段是 Google 签发 Token。 判定通过后,Google 返回一段 base64 编码的签名字符串。它有明确的有效期,通常在两分钟左右——这个时间约束会直接决定你的轮询超时和重试策略,后面会展开。
第三段在目标站点的服务端。 业务表单把 Token 随请求提交,站点后端用自己的 secret key 调用 Google 的校验接口(标准版是 siteverify,Enterprise 是 createAssessment)确认 Token 的有效性和风险指标。
关键结论:验证决策权不在页面上,而在目标站点后端。 你的脚本再怎么模拟人类行为,最终也只是影响第二段能否拿到一个「好」Token;而 Token 好不好用,取决于第三段的阈值配置。
v2、v3、Enterprise 的差别,决定你要传什么参数
这三者不是版本升级关系,行为模式完全不同,接入参数也不一样。
v2 Checkbox 与 v2 Invisible:判定是二元的,通过或不通过。信任度足够时勾选即过;不足时弹出九宫格图像质询或语音质询。通过后,前端会把 Token 写进页面里一个名为 g-recaptcha-response 的隐藏 textarea。Invisible 模式没有可见复选框,由按钮点击或 grecaptcha.execute() 触发,但 Token 落点是一样的。
v3:完全无感,不弹窗。脚本调用 grecaptcha.execute(sitekey, {action: 'login'}) 拿 Token,站点后端校验后会得到一个 0.0 到 1.0 的分数,越接近 1.0 越像真人。注意分数阈值和处置方式由目标站点自己配置,Google 不替它放行或拦截。所以 v3 场景里你必须传对 action 值,因为站点常按不同 action 设置不同阈值。
Enterprise:在 v3 评分基础上扩展了更细的风险信号和评估接口,参数形态接近 v3,但后端走 createAssessment,且站点可能启用额外的质询策略。
对接识别服务时,这三类通常对应不同的任务类型和不同的必填字段:v2 一般只要页面 URL 和 sitekey;v3/Enterprise 还要 action,有时需要期望的最低分数,以及 Enterprise 特有的附加参数。任务类型选错,返回的 Token 结构对得上、站点却不认,是最常见的第一类故障。
第一步:把参数从页面里挖出来
参数提取有三条路径,按可靠性排序:
- DOM 属性。最直接的是
.g-recaptcha元素上的data-sitekey,同一个元素上还可能有data-callback、data-action、data-s。 - JS 配置对象。挂件由
grecaptcha.render()动态创建时,DOM 上未必有属性,参数会存在___grecaptcha_cfg里。可以用page.evaluate()遍历这个对象把 sitekey 和 callback 名字取出来。 - 网络请求。抓
api.js、anchor、reload这几个请求的查询串,k参数就是 sitekey。v3 的 action 也能从reload请求体里看到。
实操建议:不要把 sitekey 写死在脚本里。目标站点换 key 或者对不同页面用不同 key 时,写死会导致大批任务返回的 Token 全部被拒,而你在日志里只会看到「提交失败」,很难定位。
第二步和第三步:创建任务并取回结果
识别服务在这里扮演的是外部 Token 计算服务,它不接管你的浏览器,也不替你维护会话。你把页面参数用 JSON 发过去,它返回一个可用的 gRecaptchaResponse。
NexCaptcha 的公开接口说明里,这一层就是标准的三个动作:createTask 创建任务拿 taskId,getTaskResult 按 taskId 查状态,getBalance 查余额;鉴权用请求体里的 clientKey,API 域名是 api.nexcaptcha.net,支持轮询和 webhook 两种取结果方式。
请求形态大致是这样(任务类型名请以当次官网说明或工程师确认为准,下面用占位标注):
// POST https://api.nexcaptcha.net/createTask —— 示意结构,非可直接运行代码
{
  "clientKey": "<你的 clientKey,不要写进仓库>",
  "task": {
    "type": "<reCAPTCHA v3 对应的任务类型名,需核验>",
    "websiteURL": "https://example.com/login",
    "websiteKey": "<从页面提取的 sitekey>",
    "pageAction": "login"
  }
}取结果时按固定间隔轮询,首次查询建议延迟 3 到 5 秒再发起,之后每 1 到 3 秒一次。status 变为 ready 时从 solution 里取 Token;返回 failed 或超时则走重试分支。
轮询超时该设多少?倒推一下:Token 有效期约两分钟,而拿到 Token 之后你还要注入、触发回调、提交表单、等服务端响应。所以识别环节的超时通常不应超过 60 到 90 秒,否则就算最后拿到 Token,也可能在提交前就过期了——表现出来是「服务返回成功但站点一直说验证失败」,很容易被误判成识别质量问题。
吞吐量大的场景(比如批量页面巡检)用 webhook 回调比轮询省资源,但要做好两件事:回调与会话的对应关系(用你自己的业务 ID 串起来),以及回调丢失时的兜底轮询。
第四步:注入 Token 并触发回调
这一步是闭环里最常被做错的地方。很多人只做了「写进 textarea」就点提交,然后发现没反应。
完整动作有三个:
// Playwright 示意,浏览器侧通用 API
await page.evaluate((token) => {
  // 1) 写入隐藏域;元素可能不止一个,且默认 display:none
  document.querySelectorAll('textarea[name="g-recaptcha-response"]')
    .forEach(el => { el.style.display = 'block'; el.value = token; });

  // 2) 若站点注册了回调,必须执行,否则表单状态不会变更
  //    回调名可能来自 data-callback,也可能藏在 ___grecaptcha_cfg 的 clients 里
  if (typeof window.onRecaptchaSuccess === 'function') {
    window.onRecaptchaSuccess(token);
  }
}, token);
3)最后才是触发提交:点按钮,或者直接构造一个带 Token 的 HTTP 请求发出去。
对 v2 Checkbox,通常写入隐藏域就够,因为表单提交时会读取该值;但如果按钮的可用状态由 callback 控制,不执行回调按钮就一直是禁用的。对 v2 Invisible 和 v3,回调几乎一定要执行,因为 Token 是由 JS 主动消费的,根本不经过静态表单字段。
还有一种更省事的做法:跳过浏览器,直接用 HTTP 客户端把 Token 拼进业务请求体。适合接口结构稳定、不依赖前端加密参数的场景,缺点是站点一改前端逻辑你就得重写。
第五步:校验业务结果,而不是只看有没有 Token
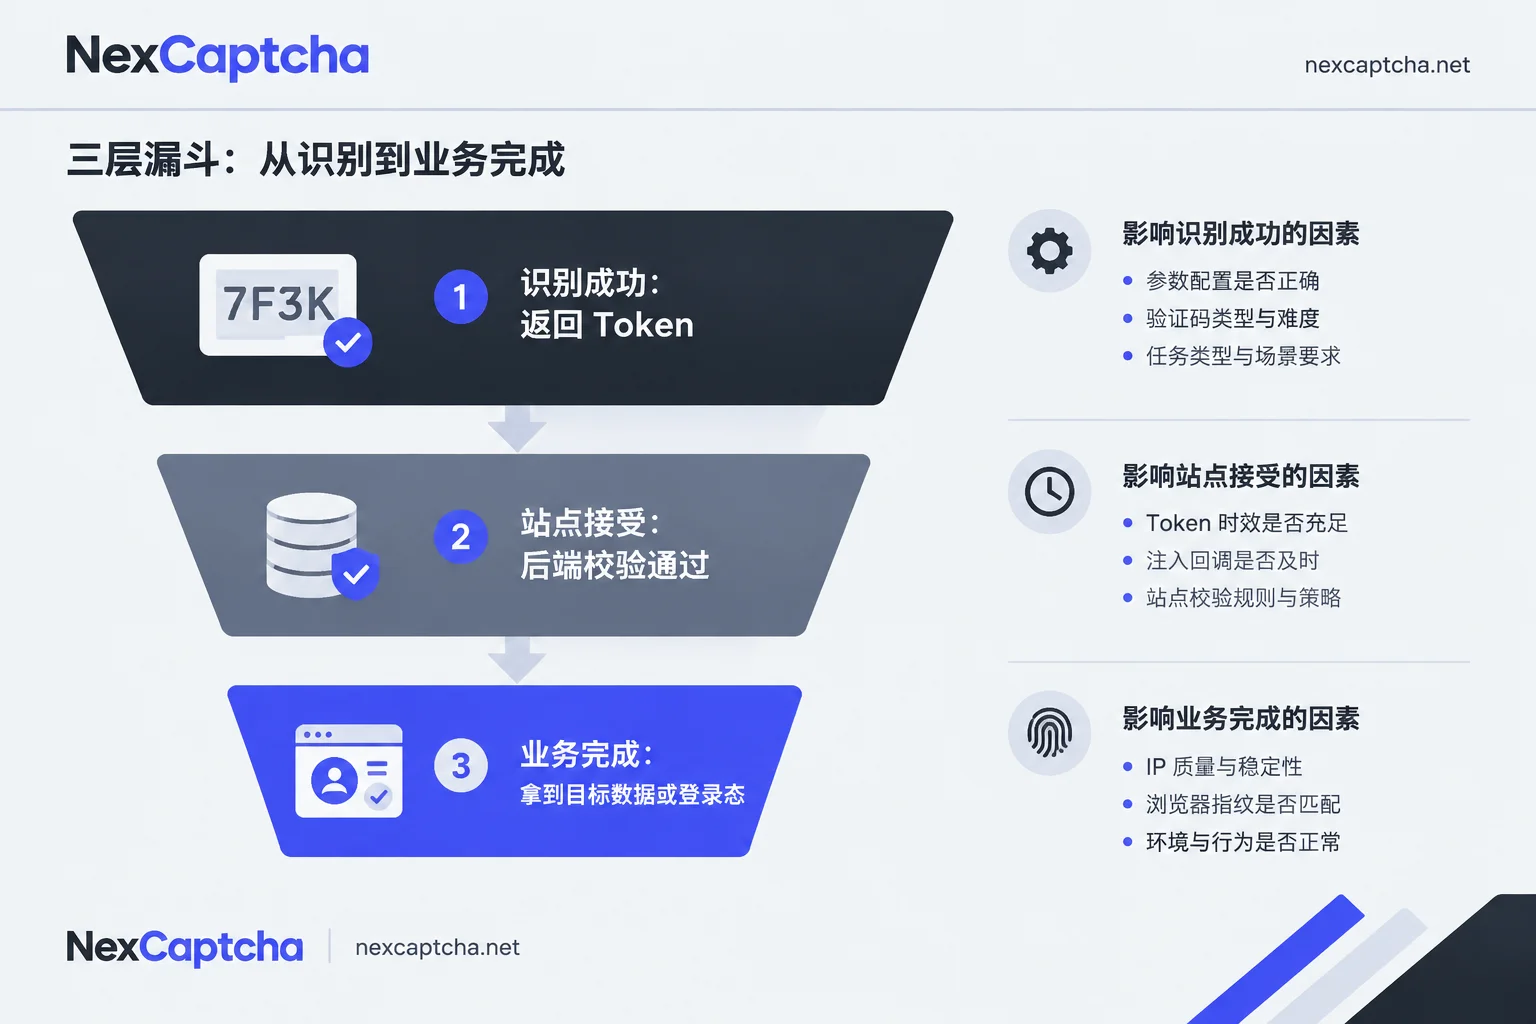
把「识别服务返回成功」当作「任务完成」,是自动化团队最常见的统计口径错误。至少要分三层看:
- 识别成功:服务返回了 Token。
- 站点接受:目标站点后端校验通过,没有再弹质询或返回验证错误。
- 业务完成:你真正想要的东西拿到了——登录态建立、数据字段非空、页面渲染到预期节点。
这三层的数字往往差得不小,尤其是 v3。评分模型会综合发出业务请求的那个客户端的 IP 信誉、浏览器指纹、请求上下文,而识别服务只负责签发 Token 这一段。
失败时按这个顺序排查,能省掉大量无效试错:
- 参数层:sitekey 是否取自当前页面?action 是否和站点期望的一致?v2/v3/Enterprise 任务类型有没有选错?
- 时效层:从创建任务到提交请求,总耗时是否逼近两分钟?重试时有没有复用已过期的旧 Token?
- 注入层:隐藏域是否存在且被正确赋值?callback 有没有执行?页面上是不是有多个 reCAPTCHA 实例而你只填了第一个?
- 环境层:发起业务请求的出口 IP,和识别服务解题时使用的网络环境是否需要保持一致?浏览器是否带着明显的自动化特征(
navigator.webdriver、异常的插件与字体列表、缺失的权限 API)? - 策略层:目标站点是否临时收紧了阈值,或叠加了 reCAPTCHA 之外的防护?
第 4 条尤其要注意:对高风控目标,Token 签发环境与实际发包 IP 的一致性经常是决定性的。是否需要在任务里绑定代理、用什么形式绑定,各家服务的字段设计不同,NexCaptcha 的这部分细则未在公开首页展开,接入前建议直接确认,不要按其他平台的字段名照搬。
把识别服务放在正确的位置上
识别 API 是工作流里的一个外部依赖,不是浏览器替身,也不是数据采集器。它不管理你的 Cookie 和会话,不负责代理轮换,不保证目标站点的业务逻辑不变。想做成稳定的全自动链路,会话管理、指纹治理、重试与幂等、结果校验这几件事仍然得由你的框架自己扛。
就选型而言,NexCaptcha 官网公开说明的几点和这条链路直接相关:用统一 REST 接口覆盖 reCAPTCHA v2/v3/Enterprise、hCaptcha、Turnstile、GeeTest、FunCaptcha 等类型(首页列出 33 种报价类型),按千次成功识别计费、失败退款并提供测试额度,同时声称对 2Captcha、Anti-Captcha、CapSolver、CapMonster 的部分任务格式兼容。需要注意的是:目录里支持某个类型,不等于你的目标站点、你的那个会话就一定能通过;迁移时也要逐个确认任务类型名的大小写、字段差异、回调形式、错误码与账单口径,「只换域名」的说法不适用于所有集成。官网展示的 P50/P95、接受率等数据是站方口径,评估时最好用自己的目标站点、同一时间窗口跑一轮小流量对照,看三层口径里的第二、三层。
具体的类型清单、价格与迁移说明,可以在 NexCaptcha 首页查看,页面上也有工程师联系入口,任务类型枚举名、是否支持代理绑定这类会影响代码的细节,建议直接问清楚再动手。
最后补一句适用范围:以上流程适用于你自有或已获授权的系统测试、无障碍辅助工具开发,以及规则允许的公开数据工作流。接入前确认目标站点的条款和你自身的授权边界,比调通任何一个参数都重要。


