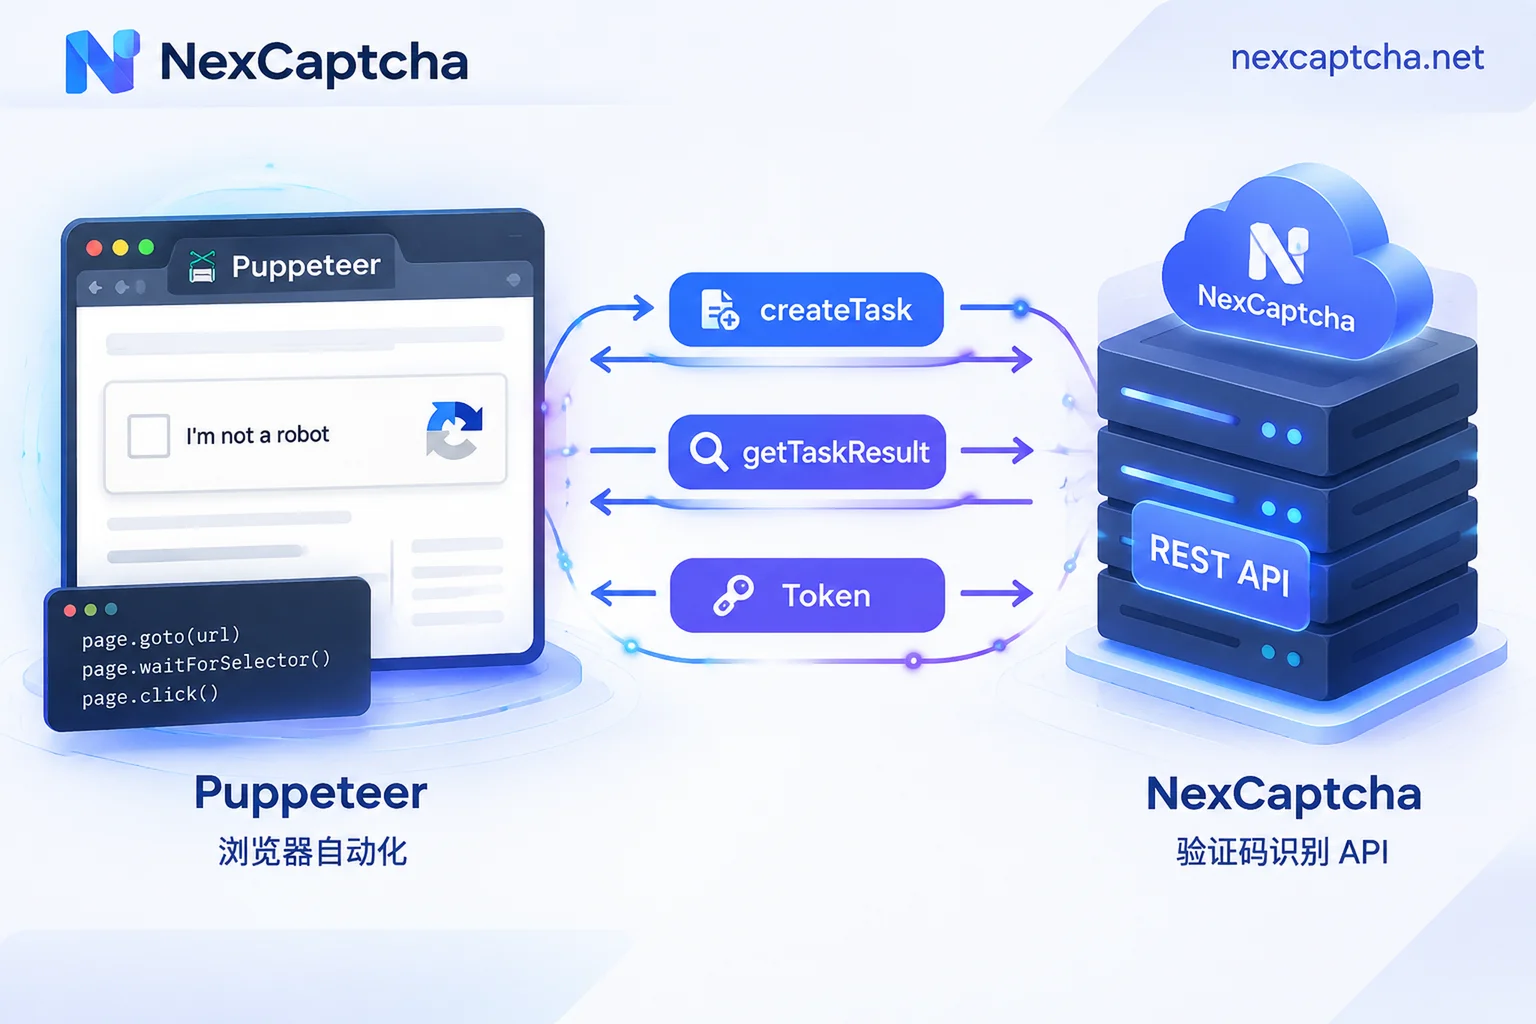
说明 Puppeteer 自动化集成验证码识别 REST API 的完整流程:动态提取 sitekey 等参数、调用接口创建任务并轮询结果、用 page.evaluate 将 Token 注入 DOM 并触发前端回调、以及排查 Token 返回后目标站仍拒绝的四个常见原因(时效过期、回调未触发、IP 不一致、自动化指纹)。
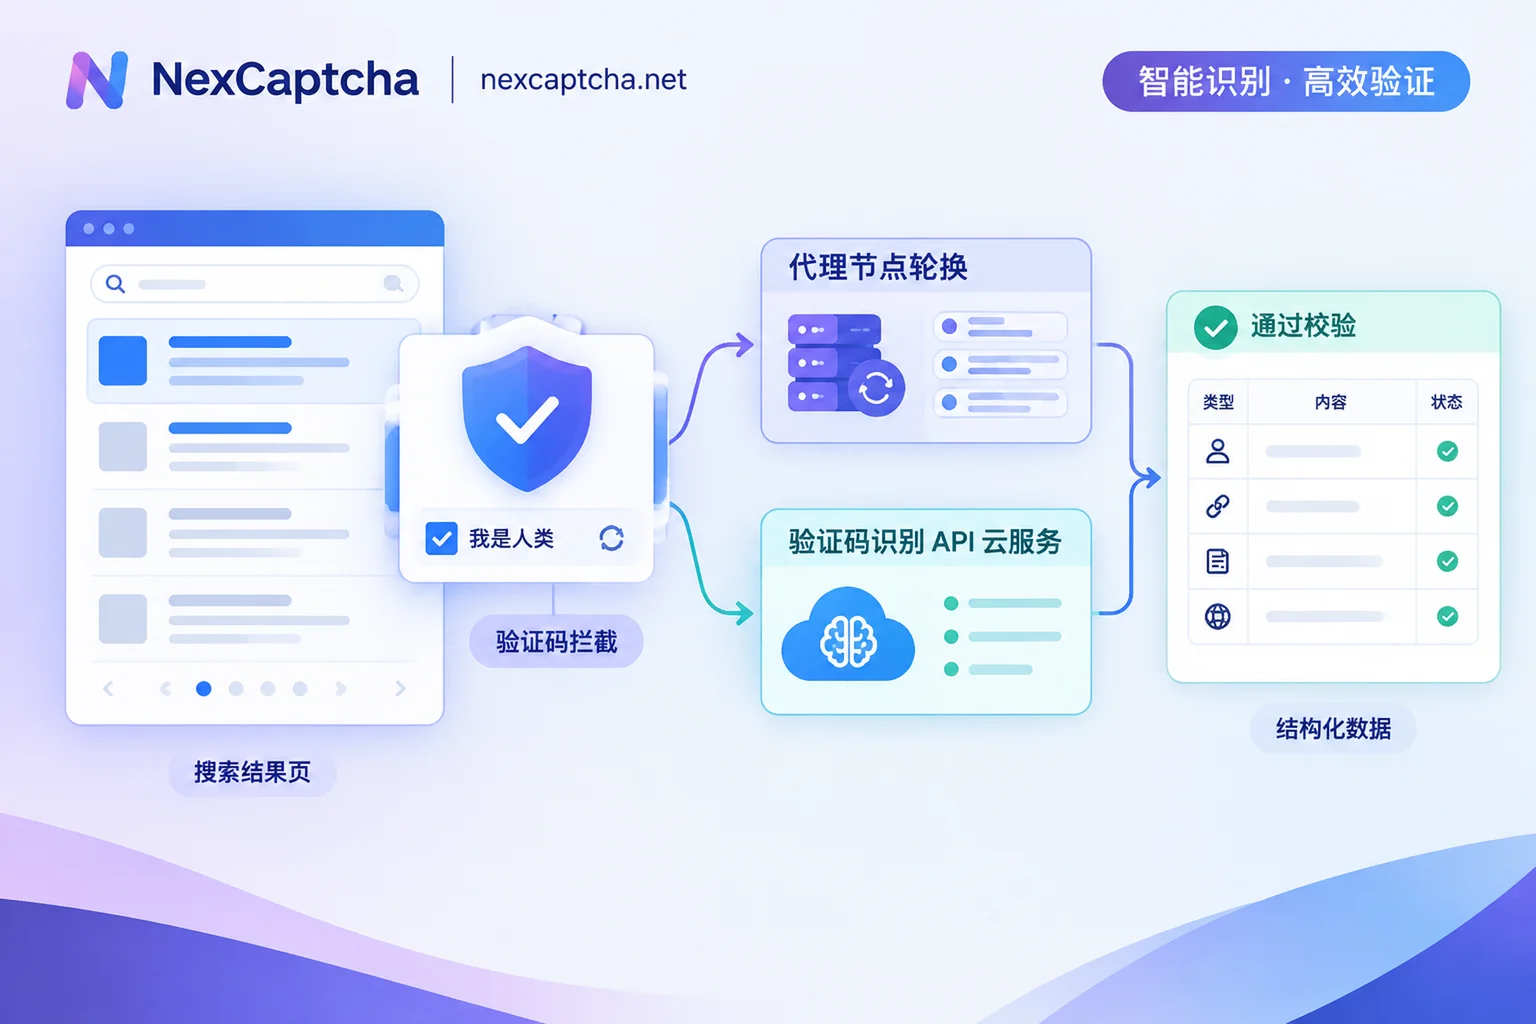
本文面向规模化 SERP 采集团队,说明如何识别 Google /sorry/ 拦截页,在隔离换 IP 与原地识别之间做选择,并给出原地识别时必须保持一致的三项上下文、token 被拒的排查顺序,以及拿到 200 后如何判断数据是否有效。
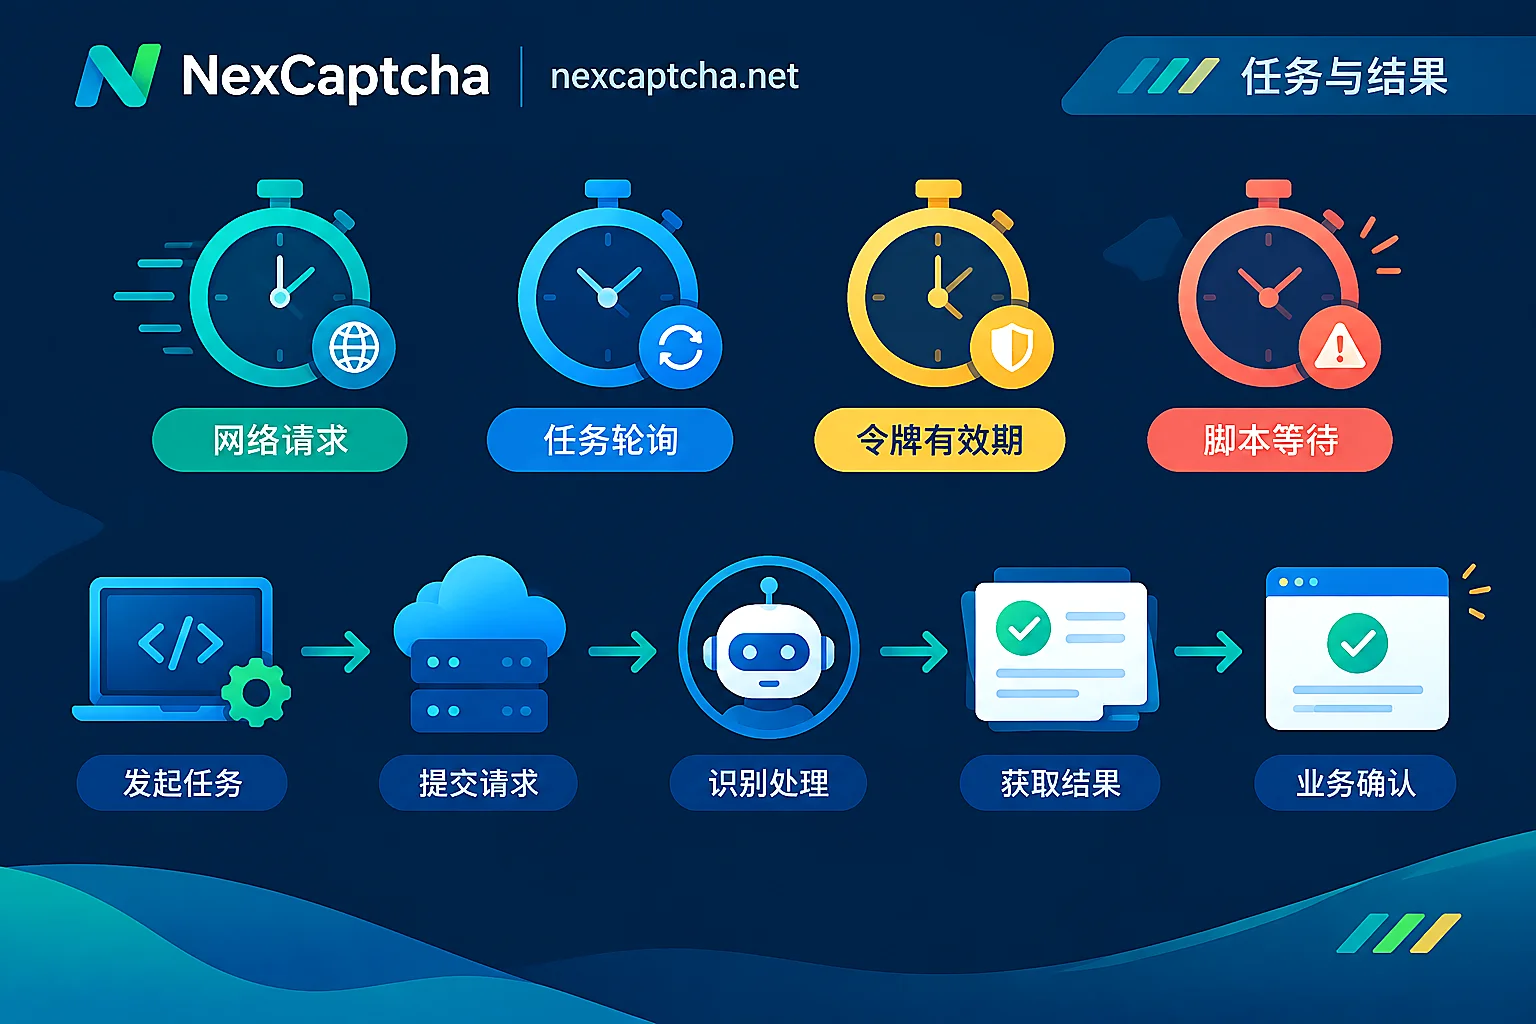
验证码API超时通常不是单一的网络问题。它可能发生在HTTP请求、任务轮询、Token有效期或自动化客户端这四个环节。本文说明如何从日志判断属于哪一种,以及各自的超时预算、轮询间隔、幂等重试、错误码止损、Token即时提交和回调替代轮询的做法,并附可对照的伪代码流程和日志字段清单。
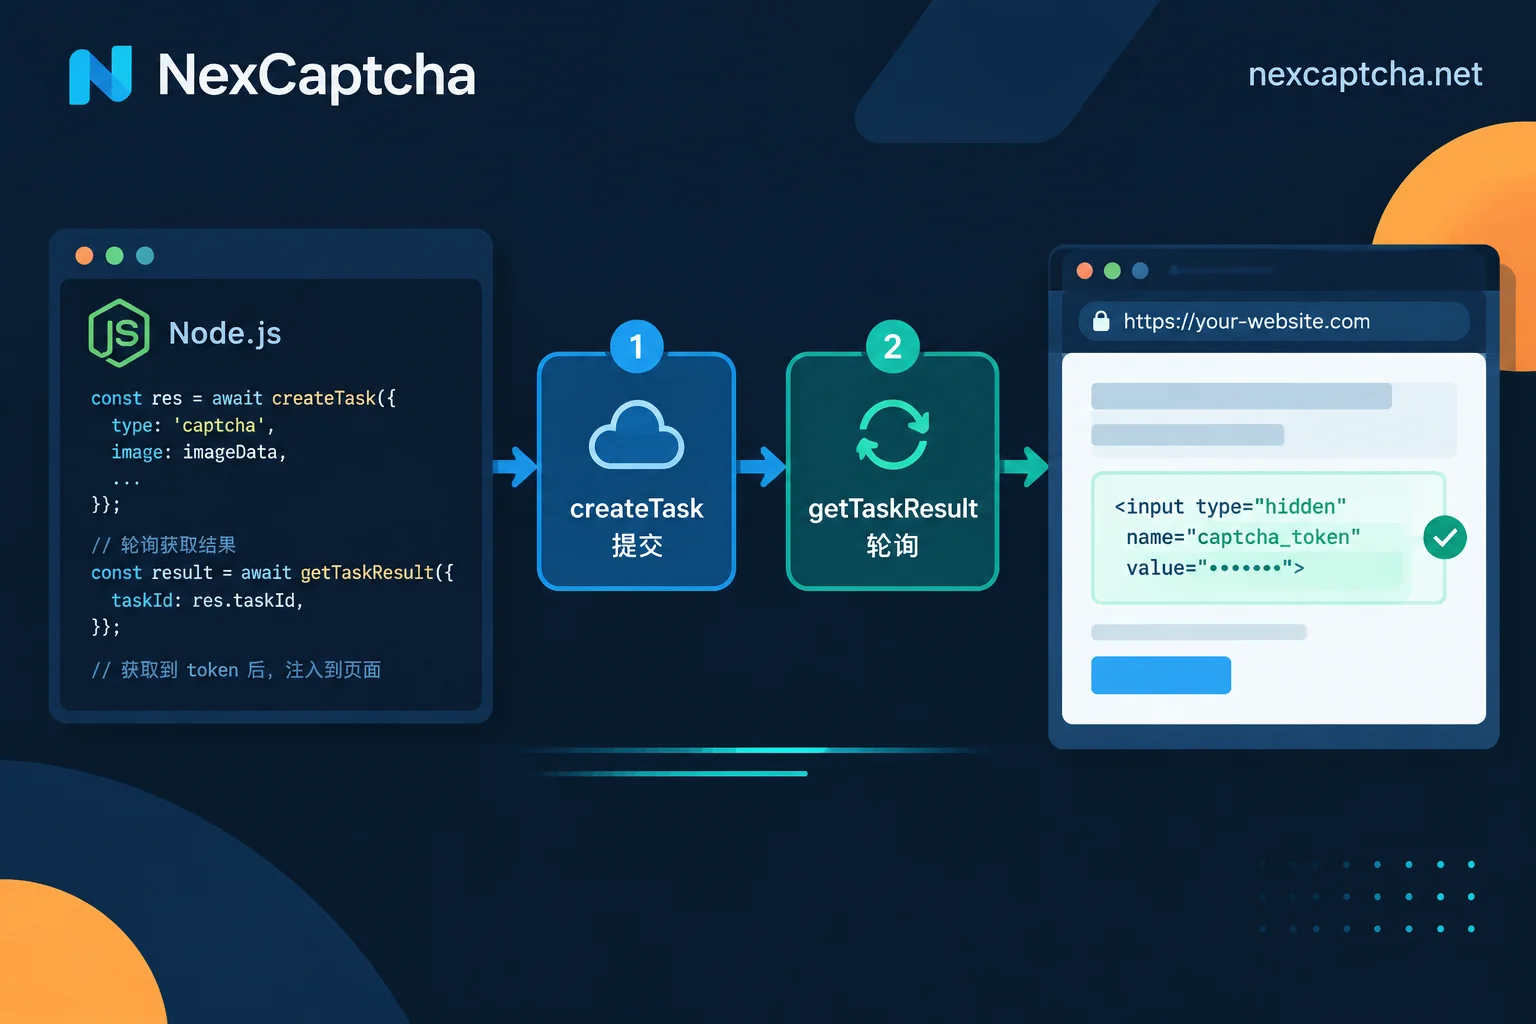
面向 Node.js 开发者,讲清验证码识别 REST API 的两段式任务流程:如何按图片类和 Token 类分别构造请求、轮询与回调怎么设超时和退避、错误该怎么分类处理,以及识别结果如何注入 Playwright/Puppeteer 页面才算真正闭环。
想替换 CapSolver 时,先确认问题出在平台还是自己的会话与代理,再按任务类型逐项盘点。本文对比 AI 加人工兜底、纯自动化和多协议兼容三类替代路线,给出“每千次业务接受成本”的算法、迁移字段检查清单和 5%~10% 小流量双跑的验证方法。