只是一个默认分类

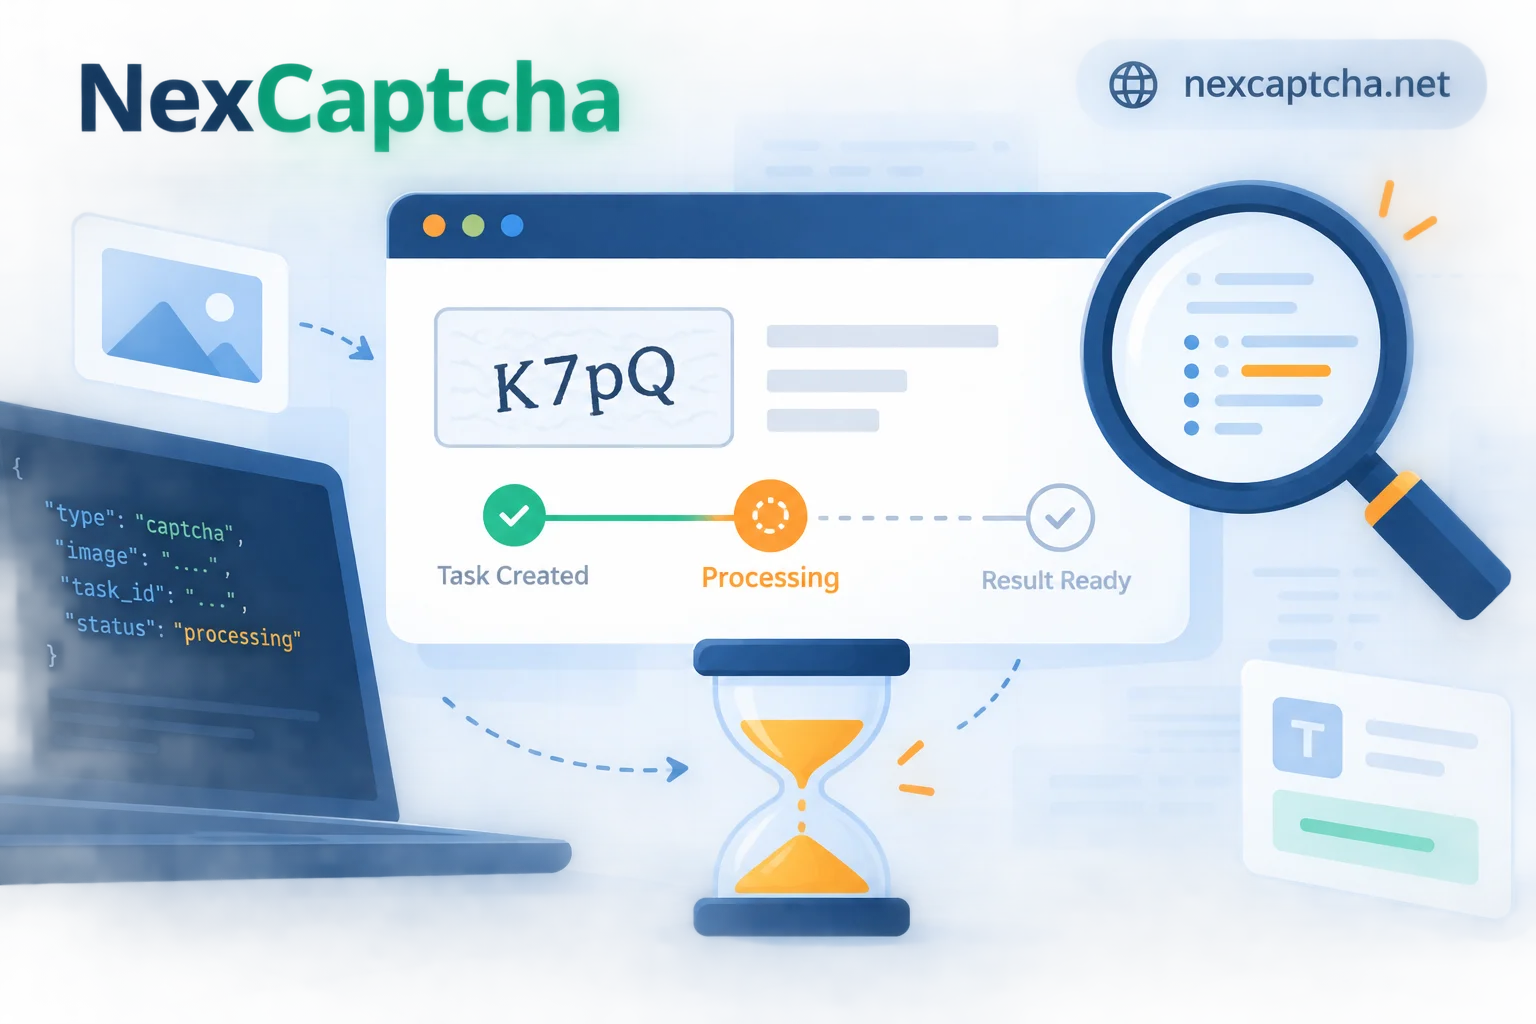
验证码任务一直 processing 怎么办:先分清“慢”和“卡”,再按顺序排查

验证码任务提交后一直处于 processing,常见原因有四类:Token 类任务本身耗时较长、轮询代码有缺陷、任务参数存在软错误,以及代理或目标站出了问题。本文给出判断方法、排查顺序和一段带总超时的轮询伪代码,并说明超时后如何重试和止损。
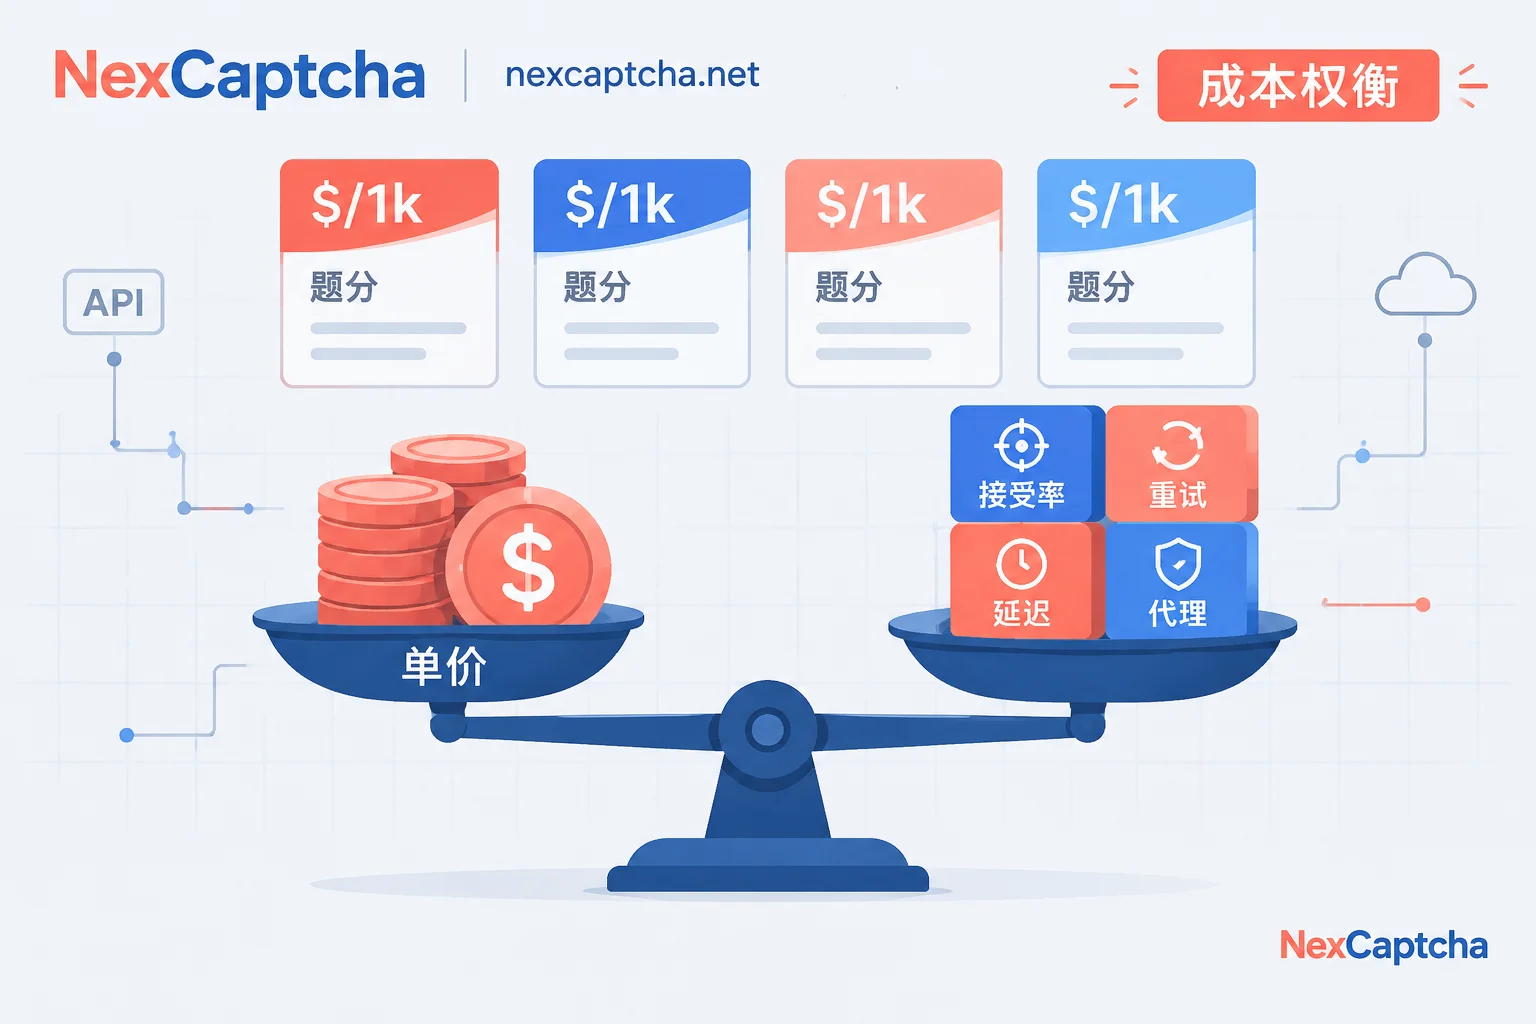
打码平台费用对比:主流平台公开报价、计费口径与真实成本算法

本文按验证码类型整理 2Captcha、CapSolver、Anti-Captcha、CapMonster Cloud 和超级鹰的公开报价区间,说明千次计费、题分制、按成功扣费和动态价格之间的差别。文章给出“每次业务成功成本”的计算方法和带假设的算例,并提供小流量对照测试步骤,帮助你判断哪家平台在自己的业务里实际更划算。

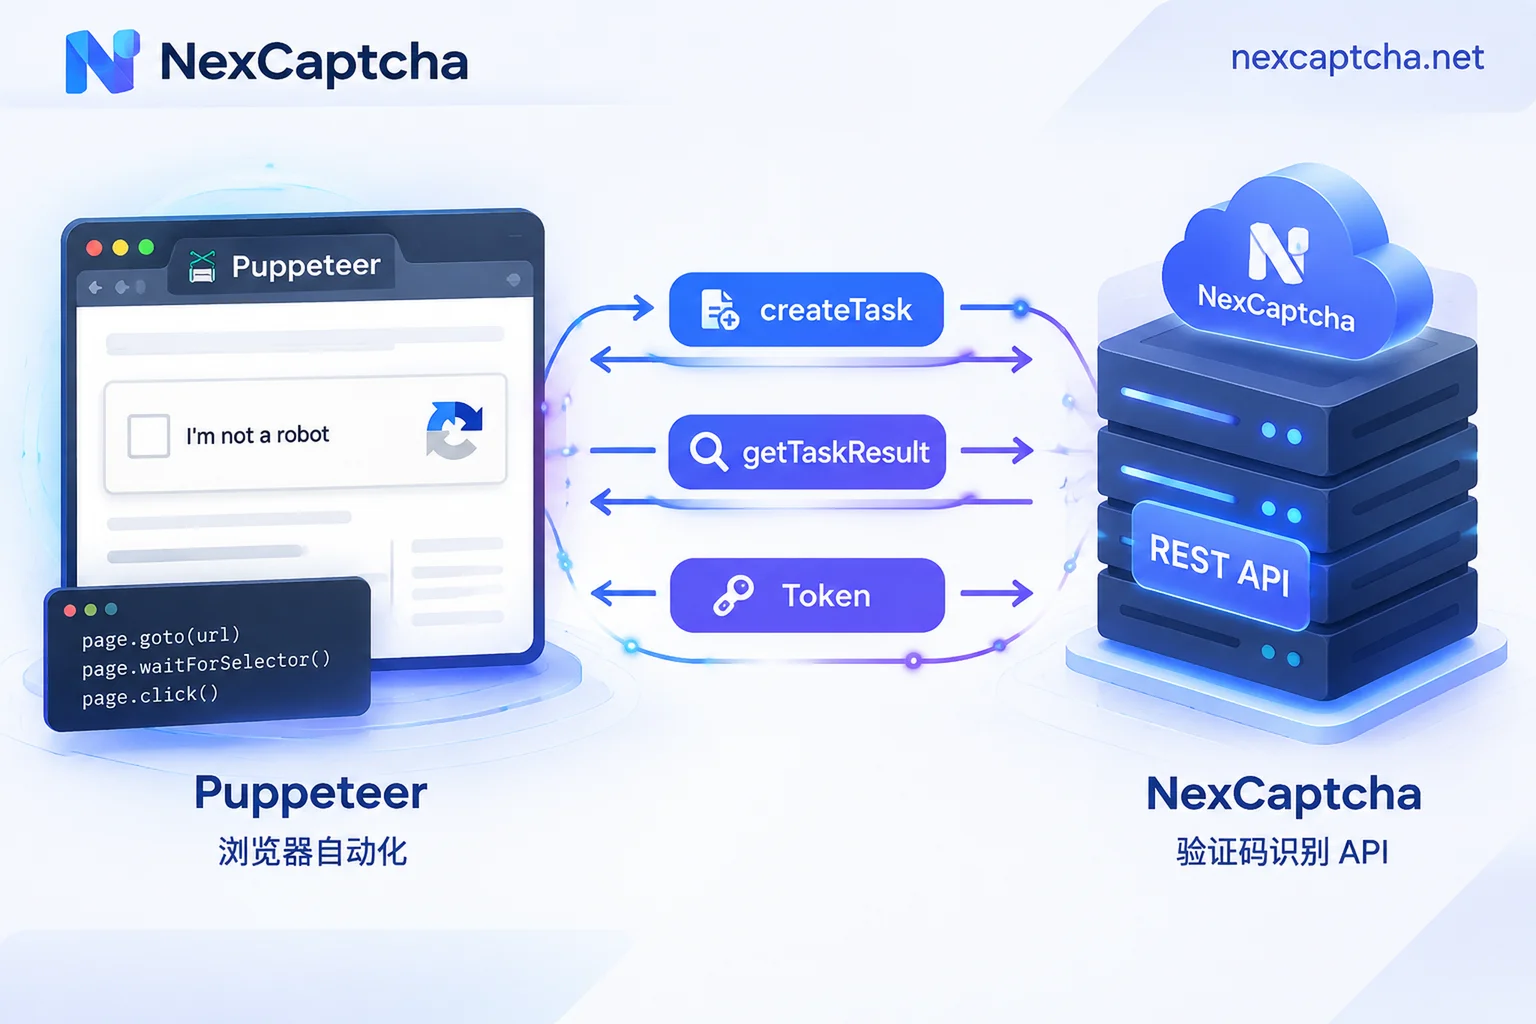
Puppeteer 验证码接口怎么接:从参数提取、Token 注入到目标站拒绝排查

说明 Puppeteer 自动化集成验证码识别 REST API 的完整流程:动态提取 sitekey 等参数、调用接口创建任务并轮询结果、用 page.evaluate 将 Token 注入 DOM 并触发前端回调、以及排查 Token 返回后目标站仍拒绝的四个常见原因(时效过期、回调未触发、IP 不一致、自动化指纹)。

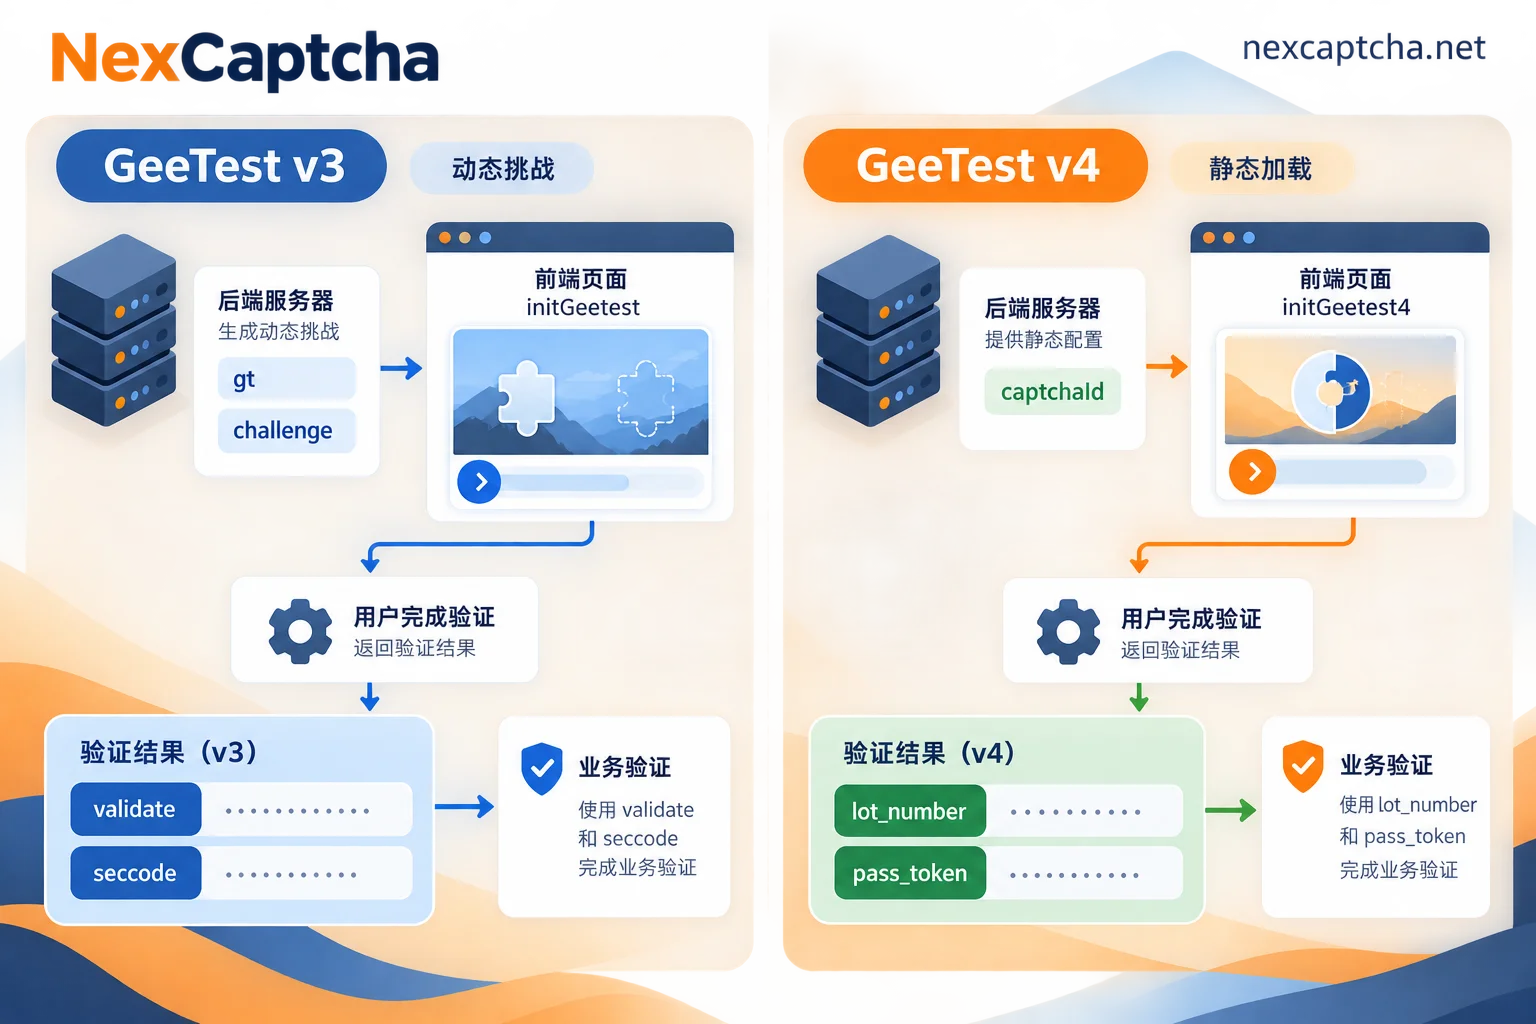
极验v3和v4区别:初始化、参数、二次校验与自动化接入的架构差异

极验v3与v4是两套独立架构。v3依赖服务端动态生成challenge,客户端用gt和challenge初始化,验证后返回validate与seccode;v4移除请求粘性,客户端直接用静态captcha_id加载SDK,引入无感验证和动态难度,返回lot_number、pass_token、captcha_output和gen_time,服务端改用HMAC-SHA256签名校验。自动化接入时,v3任务必须提取动态challenge,v4只需静态captcha_id。
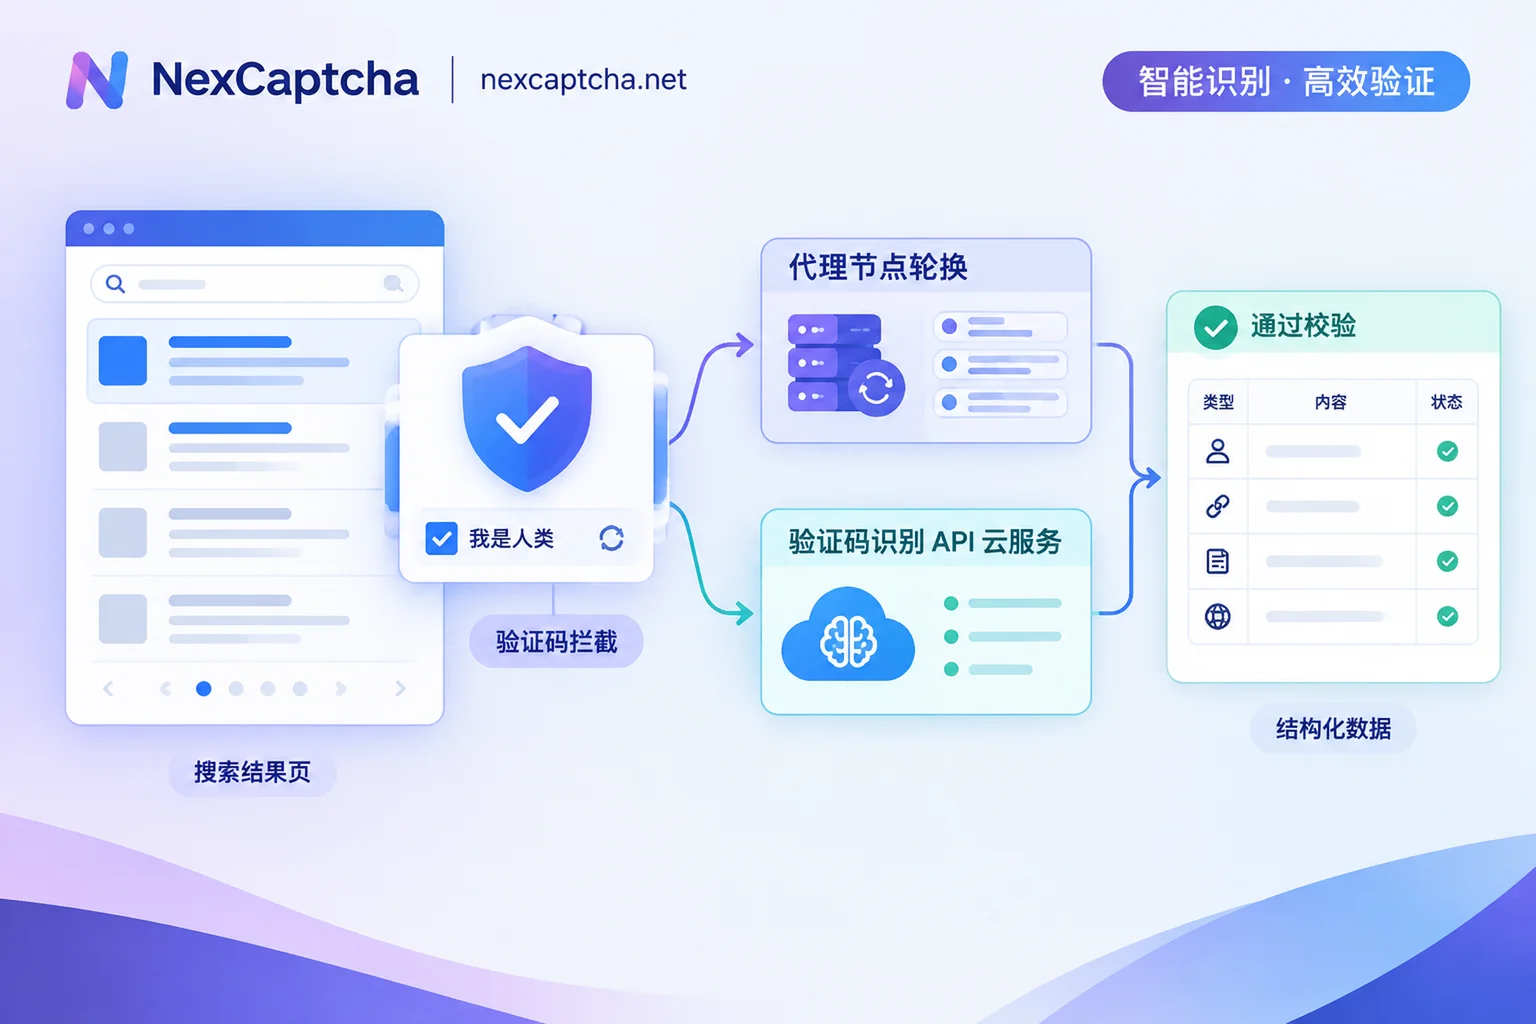
SERP采集遇到验证码怎么处理:拦截判断、换IP还是识别、token被拒与数据校验

本文面向规模化 SERP 采集团队,说明如何识别 Google /sorry/ 拦截页,在隔离换 IP 与原地识别之间做选择,并给出原地识别时必须保持一致的三项上下文、token 被拒的排查顺序,以及拿到 200 后如何判断数据是否有效。